
Escolher uma inteligência artificial para programar parece simples até que a mesma ferramenta precisa explicar uma rotina antiga, revisar uma alteração delicada e investigar um defeito que aparece somente em produção. São problemas diferentes. Usar sempre o modelo mais caro pode desperdiçar dinheiro; insistir no mais barato pode consumir o tempo que se pretendia economizar.
No caso do Google, nomes como Flash, Flash-Lite e Pro ajudam a localizar famílias, mas não substituem a leitura da documentação. O número maior também não resolve sozinho a escolha: uma versão estável e uma versão em prévia têm implicações diferentes para quem mantém um sistema empresarial.
Este artigo apresenta os modelos relevantes para assistência textual ao desenvolvimento, os preços da Gemini Developer API e os controles de raciocínio. Também propõe um roteiro de uso em Delphi e critérios para avaliar resultados. A consulta foi realizada em 2 de outubro de 2026; preços e disponibilidade precisam ser reconferidos antes da contratação ou da implantação.
Uma janela de contexto maior ou outro modelo não resolve, por si só, o projeto da integração. IA Além da Conversa aprofunda como organizar contexto, dados, ferramentas, permissões, avaliação e custos ao redor do modelo. Conheça a proposta e leia a degustação gratuita para avaliar esse percurso além da comparação de preços. Se a tarefa é evoluir uma aplicação Delphi existente, Delphi Vivo complementa a leitura com diagnóstico de dependências, testes e modernização incremental.
Antes da comparação: modelo, ferramenta e contexto
Um modelo de linguagem é o componente que recebe informações e produz uma resposta. A ferramenta é o ambiente que organiza essa interação: conversa, editor, integração própria ou agente. Um agente, neste contexto, é um programa que pode solicitar ações a ferramentas, observar resultados e continuar o trabalho. Não significa que essas ações sejam automaticamente corretas ou seguras.
A API, interface de programação de aplicações, permite que um software envie solicitações ao modelo. Os preços discutidos aqui são da Gemini Developer API, não uma estimativa de assinatura do aplicativo Gemini nem de qualquer serviço que ofereça acesso aos mesmos nomes. Essa delimitação importa porque não existe uma tarifa universal para toda experiência comercial com Gemini.
Chamamos de contexto o material disponível para a solicitação: instruções, código, registros de erro e documentos. Esse material é contabilizado em tokens, unidades de processamento que podem corresponder a partes de palavras ou outros elementos. Token não é sinônimo de palavra; uma unidade Delphi, com identificadores e símbolos, não deve ser orçada simplesmente pela quantidade de linhas.
Também é necessário distinguir versões. Na documentação de modelos, uma versão estável tem um identificador próprio; uma prévia permite experimentar recursos ainda sujeitos a condições de evolução diferentes. Um apelido como latest pode mudar o modelo apontado. Para uma integração que precisa ser auditável, prefira registrar exatamente qual identificador foi usado.
Quais modelos entram na decisão
A documentação consultada recomenda Gemini 3.8 Flash ou Gemini 3.5 Flash-Lite para novos projetos. Há outros modelos no catálogo, incluindo versões anteriores de Flash, mas uma comparação útil não precisa transformar todas as opções em escolhas igualmente recomendáveis. O recorte abaixo combina os dois pontos de entrada atuais com a opção Pro em prévia.
Gemini 3.5 Flash-Lite: tarefas delimitadas e repetidas
O Gemini 3.5 Flash-Lite é apresentado pelo Google como uma opção de baixa latência e custo eficiente para alto volume, extração simples e processamento de documentos. Seu identificador é gemini-3.5-flash-lite.
Para programação, eu o consideraria primeiro em tarefas com resposta fácil de conferir: classificar mensagens de erro, organizar uma lista de alterações, propor documentação para uma rotina curta ou extrair informações de um registro. Essas aplicações são recomendações editoriais, não resultados de testes comparativos realizados neste artigo.
O limite dessa estratégia aparece quando a tarefa envolve dependências pouco explícitas. Explicar uma função isolada não é o mesmo que garantir que sua alteração preserva o comportamento de um módulo inteiro. Se a resposta exigir várias rodadas para descobrir contexto ausente, a economia inicial pode desaparecer.
Gemini 3.8 Flash: ponto de partida para manutenção
O Gemini 3.8 Flash é uma versão estável, identificada por gemini-3.8-flash. O Google descreve seu foco em engenharia de software de longo percurso, agentes e fluxos empresariais complexos. Essa descrição é do fornecedor, não comprovação de superioridade em todo projeto.
Como hipótese de trabalho, usaria essa opção para revisão de alterações, manutenção com contexto de várias unidades e planejamento de testes. Um problema que exige acompanhar relações entre entrada, regra de negócio e persistência merece uma avaliação mais completa do que a necessária para reescrever um comentário.
A decisão deve permanecer aberta aos resultados. Se o Flash-Lite resolver uma classe de solicitações com qualidade suficiente, não há obrigação de transferi-las para Flash. Da mesma forma, uma resposta convincente do Flash precisa passar pelos testes do projeto antes de justificar qualquer alteração real.
Gemini 3.1 Pro: avaliação controlada, não promoção automática
O Gemini 3.1 Pro está em prévia, com o identificador gemini-3.1-pro-preview. A documentação destaca engenharia de software, uso preciso de ferramentas e fluxos com múltiplas etapas.
Eu o incluiria em uma avaliação controlada de problemas difíceis: hipóteses concorrentes sobre um defeito, discussão arquitetural ou revisão de uma mudança de grande impacto. Isso não significa que o nome Pro garanta resultado melhor que um Flash mais recente. São perfis que precisam ser confrontados com a mesma tarefa e os mesmos critérios.
A condição de prévia deve entrar no plano de operação. Antes de torná-lo dependência central, verifique disponibilidade, limites e estratégia de substituição. Experimentar um modelo em um diagnóstico assistido é uma decisão diferente de usá-lo como componente obrigatório de um processo que não pode parar.
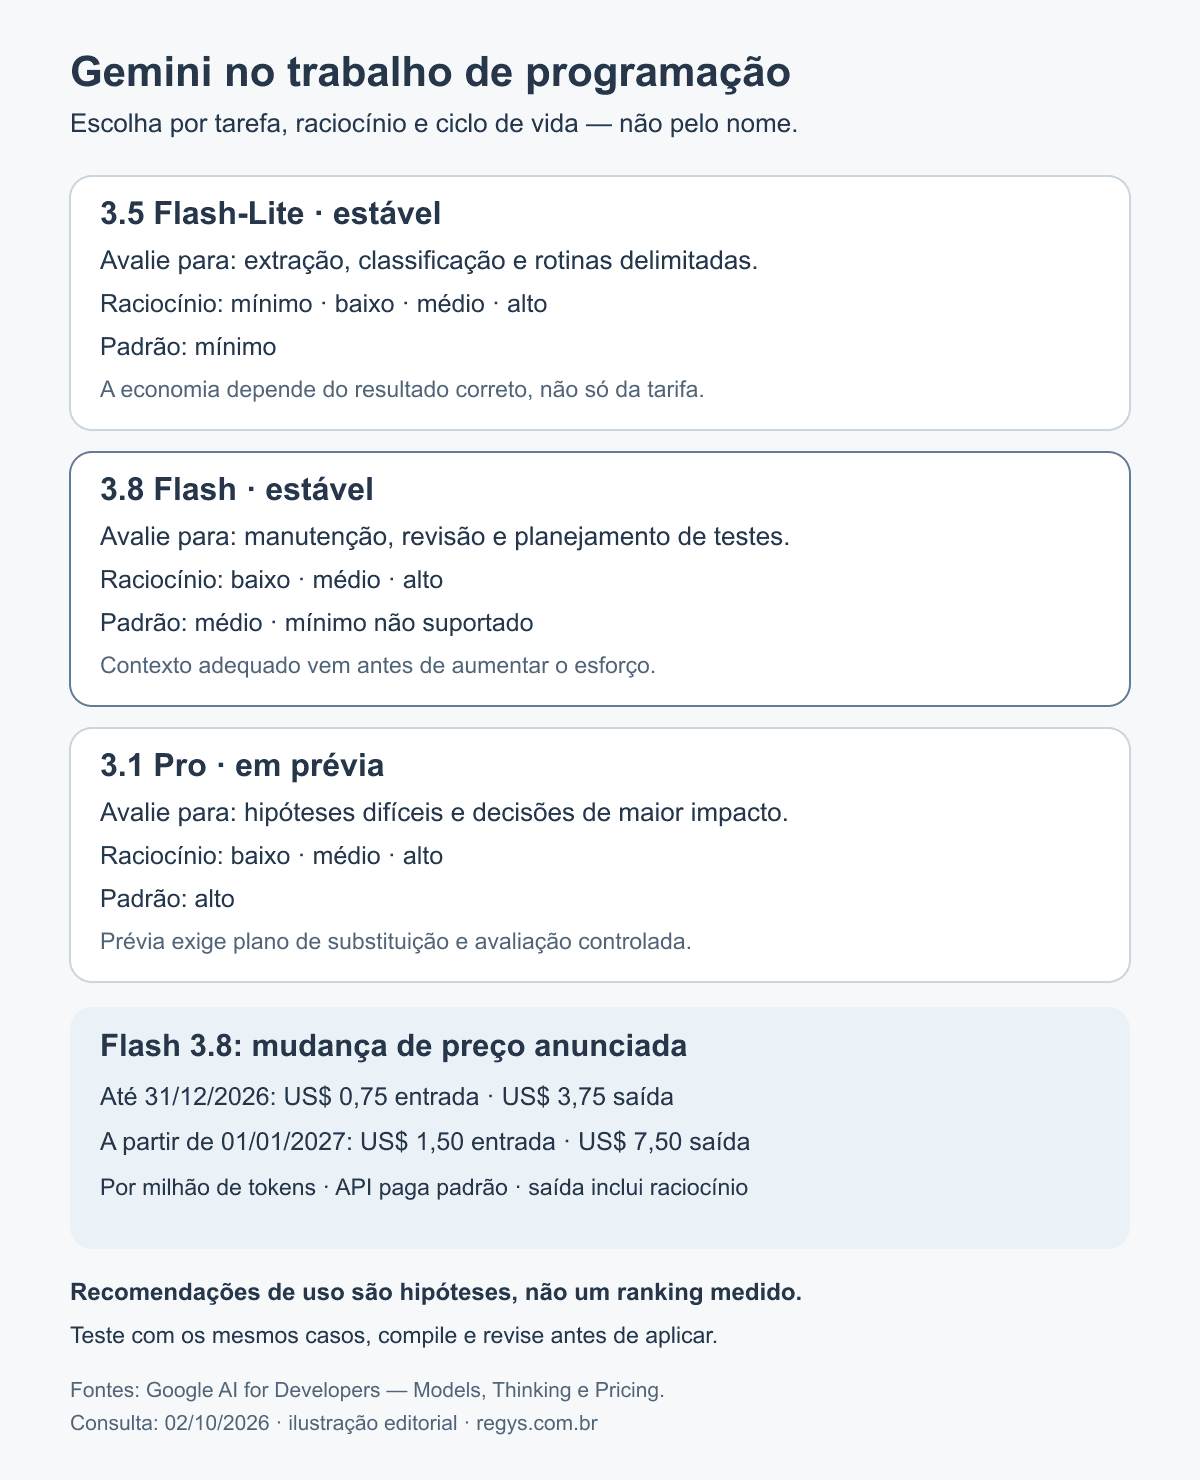
Guia ilustrativo de decisão, sem ranking universal. Fontes: documentação Google de modelos, raciocínio e preços, consultada em 2 out. 2026.
Raciocínio: quando usar mínimo, baixo, médio e alto
Raciocínio, neste assunto, é o processamento intermediário empregado pelo modelo para preparar a resposta. A documentação de raciocínio apresenta o parâmetro thinking_level nos exemplos da API Interactions, uma das interfaces de solicitação do serviço. Os valores disponíveis dependem do modelo; a configuração concreta deve seguir a interface utilizada. Não existe correspondência direta com os nomes de esforço oferecidos por OpenAI ou Anthropic.
No Flash-Lite 3.5, estão disponíveis mínimo (minimal), baixo (low), médio (medium) e alto (high), com mínimo como padrão. No Flash 3.8, os níveis são baixo, médio e alto, com médio como padrão; mínimo não é suportado. No Pro 3.1 em prévia, há baixo, médio e alto, com alto como padrão. Não há nível ultra documentado para essas opções.
Para uma tarefa simples e bem especificada, comece pelo menor nível disponível que produza resultado adequado. Pedir uma descrição curta de uma rotina não costuma justificar a mesma configuração de uma investigação sobre concorrência. Ainda assim, essa é uma proposta de avaliação, não uma garantia de desempenho.
Use médio como experimento para atividades com algumas relações e alternativas: revisar uma alteração, propor testes ou explicar um fluxo com mais de uma etapa. Considere alto quando o erro seria caro e a análise precisa comparar hipóteses, discutir consequências e justificar escolhas. O ganho deve aparecer na qualidade verificada, não apenas no tamanho da resposta.
Aumentar raciocínio não fornece arquivos que faltam nem transforma uma suposição em evidência. Antes de elevar o nível, confira se o modelo recebeu o comportamento esperado, o erro observado e as restrições. Uma solicitação incompleta continua incompleta, mesmo quando custa mais para processar.
Preços: o orçamento precisa ter data
Na modalidade paga padrão, os valores por milhão de tokens de entrada e de saída são: Flash-Lite 3.5, US$ 0,30 e US$ 2,50; Flash 3.8, US$ 0,75 e US$ 3,75 até 31 de dezembro de 2026, passando a US$ 1,50 e US$ 7,50 em 1º de janeiro de 2027. A mudança está anunciada na tabela oficial de preços.
Para o Pro 3.1 em prévia, as tarifas são US$ 2,00 e US$ 12,00 quando a entrada tem até 200 mil tokens, ou US$ 4,00 e US$ 18,00 acima desse limite. A saída cobrada inclui tokens de raciocínio; não considere somente o texto visível.
Um cálculo hipotético com 100 mil tokens de entrada e 20 mil de saída faturável resulta em US$ 0,08 no Flash-Lite, US$ 0,15 no Flash antes da mudança e US$ 0,30 depois dela, ou US$ 0,44 no Pro. Não é estimativa de consumo típico. Desconsidera impostos, câmbio, ferramentas e cache.
Mais importante que o custo de uma solicitação é o custo de concluir uma tarefa corretamente. Registre tentativas, consumo, tempo de revisão e testes aprovados. Uma resposta barata que exige correção extensa pode ser mais cara para a equipe do que outra que chega a uma solução verificável em menos rodadas.
Como aplicar no trabalho diário com Delphi
Uma boa solicitação começa pelo problema, não pelo nome do modelo. A orientação de elaboração de instruções do Google recomenda clareza, contexto e formato esperado. Na prática, isso significa explicar quais informações são fatos e quais ainda precisam ser investigadas.
Considere uma rotina de arredondamento em um sistema financeiro. Não basta solicitar “melhore este código”. Informe a versão do Delphi, os tipos utilizados, a regra de negócio aprovada e casos que demonstram o problema. O exemplo abaixo é uma instrução ilustrativa; nenhum código foi executado ou validado por um compilador neste artigo.
Contexto: projeto Delphi 12, código Object Pascal.
Problema: o total apresentado diverge do total esperado em alguns casos.
Regra: vou fornecer a política de arredondamento aprovada e exemplos.
Material: rotina atual, entradas, resultados obtidos e resultados esperados.

Primeiro explique o comportamento observado e liste informações ausentes.
Depois proponha uma alteração mínima, sem inventar regras financeiras.
Sugira testes para valores positivos, negativos e limites de arredondamento.
Não afirme que compilou ou executou algo sem apresentar o resultado real.
Para extrair os casos fornecidos e organizar a descrição, avalie Flash-Lite com esforço mínimo ou baixo. Para analisar a rotina e propor testes, experimente Flash com médio. Se persistirem hipóteses conflitantes, compare Flash com alto e Pro em prévia, mantendo exatamente os mesmos dados de entrada.
Essa progressão evita trocar de modelo antes de compreender por que uma tentativa falhou. Talvez a regra tenha sido descrita de forma ambígua; talvez o defeito esteja em outra etapa do fluxo. Pedir que o modelo indique o que não sabe é útil porque torna lacunas visíveis antes de uma sugestão virar código.
O resultado deve entrar em uma cópia de trabalho, passar pelo compilador e pelos testes e ser revisado por quem conhece o domínio. A experiência com IA aplicada a Delphi, Lazarus e ACBr ajuda a contextualizar essa colaboração. O modelo participa da análise; a responsabilidade pela mudança continua com a equipe.
Contexto grande, ferramentas e limites não eliminam riscos
As fichas dos três modelos indicam entrada de até 1.048.576 tokens e saída de até 65.536. Isso permite trabalhar com material extenso, mas o limite é uma capacidade técnica, não uma instrução para enviar todo o repositório. Escolha primeiro os arquivos relacionados ao defeito e explique suas relações.
Quando uma integração aciona ferramentas, revise permissões e resultados separadamente. Uma proposta de comando não deve ganhar acesso irrestrito a banco, arquivos ou publicação apenas porque veio de um modelo. A evolução do RadIA mostra a importância do ambiente de integração; a escolha do modelo é somente parte dessa arquitetura.
Para material repetido, considere o armazenamento reutilizável de contexto, ou cache, seguindo a documentação específica. Avalie elegibilidade, duração e custo antes de presumir economia. Guardar conteúdo que não será reutilizado não é necessariamente uma otimização.
Preço também não define capacidade operacional. Os limites de uso variam por modelo e condições do projeto. Teste o volume esperado e planeje tratamento de falhas antes de automatizar solicitações em massa. Proteja segredos e dados de clientes e confira as condições de tratamento de dados do serviço escolhido.
Desligamentos: o que está anunciado e o que não está
Na página de descontinuações, o Google esclarece que as datas indicadas representam o momento mais cedo possível para desligamento, com comunicação antecipada da data exata. Para gemini-3.1-flash-lite, consta 7 de maio de 2027, com migração recomendada para gemini-3.5-flash-lite.
Para Flash 3.8, Flash-Lite 3.5 e Pro 3.1 em prévia, não havia data de desligamento anunciada na consulta. Isso não equivale a uma promessa de manutenção permanente.
Outro cuidado são os modelos 2.5 Pro, Flash e Flash-Lite. A documentação informa acesso restrito a usuários que já os utilizavam, embora não estejam classificados como descontinuados e permaneçam disponíveis até novo aviso. Não trate ausência de data como recomendação para uma integração nova.
Mantenha o identificador do modelo em configuração, registre a versão nos diagnósticos e preserve um conjunto de tarefas para comparação. Quando houver migração, execute novamente os mesmos casos. Trocar uma identificação e observar que a API respondeu não basta para demonstrar que o comportamento necessário foi preservado.
Conclusão
Escolher Gemini para programação envolve três decisões relacionadas: o modelo, o nível de raciocínio e o modo de utilização. Flash-Lite é um candidato para trabalho delimitado e repetido; Flash merece avaliação como opção de manutenção; Pro em prévia pode integrar testes de problemas difíceis. Essas são hipóteses para orientar experimentos, não posições fixas em um pódio.
A melhor configuração é a que conclui a tarefa com qualidade verificável e custo aceitável. Comece com contexto suficiente, aumente a complexidade quando houver evidência de necessidade e meça o trabalho completo. Para contratos e sistemas que atravessarão 2027, inclua desde já a mudança tarifária do Flash e a revisão periódica do ciclo de vida no planejamento.
Escolher uma configuração é o início da integração, não seu projeto completo. Para aprofundar as decisões de contexto, recuperação, permissões e operação, IA Além da Conversa organiza esse percurso sem depender de uma família de modelos. A página apresenta sumário e degustação gratuita: use-os para verificar se a leitura atende ao próximo desafio do seu sistema.
Referências
GOOGLE. Context caching. Google AI for Developers, 2 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/caching. Acesso em: 2 out. 2026.
GOOGLE. Gemini 3.1 Pro Preview. Google AI for Developers, 18 ago. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/models/gemini-3.1-pro-preview. Acesso em: 2 out. 2026.
GOOGLE. Gemini 3.5 Flash-Lite. Google AI for Developers, 30 jul. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/models/gemini-3.5-flash-lite. Acesso em: 2 out. 2026.
GOOGLE. Gemini 3.8 Flash. Google AI for Developers, 2 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash. Acesso em: 2 out. 2026.
GOOGLE. Gemini deprecations. Google AI for Developers, 1 out. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/deprecations. Acesso em: 2 out. 2026.
GOOGLE. Gemini Developer API pricing. Google AI for Developers, 1 out. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/pricing. Acesso em: 2 out. 2026.
GOOGLE. Gemini thinking. Google AI for Developers, 25 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/thinking. Acesso em: 2 out. 2026.
GOOGLE. Models. Google AI for Developers, 1 out. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/models. Acesso em: 2 out. 2026.
GOOGLE. Prompt design strategies. Google AI for Developers, 17 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/prompting-strategies. Acesso em: 2 out. 2026.
GOOGLE. Rate limits. Google AI for Developers, 2 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/rate-limits. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Delphi Vivo. 1. ed. 2026. Disponível em: https://livros.regys.com.br/delphi-vivo. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. IA na prática com Delphi, Lazarus e ACBr: aprendizados do Papo Pro. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/ia-na-pratica-com-delphi-lazarus-e-acbr-aprendizados-do-papo-pro/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. RadIA 2.17.18: evolução desde a versão 2.15. regys.com.br, 2 out. 2026. Disponível em: https://regys.com.br/radia-2-17-18-evolucao-desde-versao-2-15/. Acesso em: 2 out. 2026.
Descubra mais sobre Régys Borges da Silveira
Assine para receber nossas notícias mais recentes por e-mail.

Dê-nos sua opinião, seu comentário ajuda o site a crescer e melhorar a qualidade dos artigos.