
Uma inteligência artificial pode explicar uma função rapidamente e, na solicitação seguinte, precisar investigar vários módulos para encontrar um erro intermitente. Tratar esses dois trabalhos como iguais costuma levar a uma escolha ruim: pagar capacidade que não será aproveitada ou economizar na chamada e gastar mais tempo corrigindo a resposta. Para quem mantém sistemas empresariais, interessa o custo da alteração confiável, não apenas o preço da resposta.
A proposta deste artigo é comparar os modelos Claude da Anthropic pela perspectiva do desenvolvimento cotidiano. O recorte, consultado em 2 de outubro de 2026, reúne Haiku 4.5, Sonnet 5.5, Opus 5.5 e Fable 5.1, com preços da API, controles de raciocínio, critérios de avaliação e prazos de migração. As sugestões de uso são pontos de partida para testes, não resultados de uma competição executada neste projeto.
Se a dificuldade não é obter outra resposta, mas definir o que uma alteração deve preservar, SDD em Delphi aprofunda especificações, contratos, casos de fronteira e critérios de aceite ligados à implementação e aos testes. Conheça a proposta e leia a degustação gratuita para avaliar como orientar sua próxima demanda com apoio de IA. Para estudar contexto, ferramentas, permissões e avaliação da solução que utiliza o modelo, a leitura complementar é IA Além da Conversa.
Primeiro, separe modelo, produto e integração
Um modelo de linguagem interpreta entradas e gera respostas. Claude é o nome da família; Haiku, Sonnet, Opus e Fable identificam linhas de modelos. Já Claude Code é uma ferramenta de desenvolvimento que utiliza modelos, arquivos e outras ferramentas em um fluxo de trabalho. Um agente combina essas capacidades para realizar etapas sucessivas, como investigar, alterar código e executar testes.
A API é a interface pela qual uma aplicação envia solicitações e recebe respostas. Seus preços por uso não equivalem à mensalidade de um produto. A disponibilidade de um modelo e os controles exibidos também dependem do ambiente. Antes de comparar valores, confirme se está usando a API direta, uma assinatura ou um serviço intermediário, conforme a documentação de configuração do Claude Code.
Também vale distinguir o modelo de seu esforço: escolher um modelo define uma capacidade disponível; configurar esforço orienta quanto trabalho ele dedica à resposta. É parecido com escolher uma ferramenta e depois ajustar sua utilização, mas a analogia tem limite: nenhuma configuração transforma uma resposta probabilística em uma prova de correção.
Os modelos atuais e os preços de referência
Tokens são unidades em que texto e código são processados, não uma contagem exata de palavras. Entrada corresponde ao conteúdo enviado; saída inclui o conteúdo gerado e, quando houver, raciocínio faturável. Cache é a reutilização de conteúdo previamente processado. A tabela mostra tarifas por milhão de tokens na API direta, sem ferramentas, impostos, câmbio ou modalidades especiais.
| Modelo e identificador | Entrada | Saída | Leitura de cache |
|---|---|---|---|
Haiku 4.5: claude-haiku-4-5-20251001 | US$ 1 | US$ 5 | US$ 0,10 |
Sonnet 5.5: claude-sonnet-5-5 | US$ 2 | US$ 10 | US$ 0,20 |
Opus 5.5: claude-opus-5-5 | US$ 4 | US$ 20 | US$ 0,20 |
Fable 5.1: claude-fable-5-1 | US$ 10 | US$ 50 | US$ 0,25 |
Fonte: preços oficiais da Anthropic, consultados em 2 out. 2026. Gravar conteúdo em cache tem tarifa própria, diferente de lê-lo.
O catálogo atual sugere Opus 5.5 como início para a maioria das cargas de trabalho e Fable 5.1 para raciocínio exigente ou tarefas longas quando a avaliação com Opus não basta. Essa é a orientação do fornecedor, não uma obrigação de encaminhar qualquer pedido ao modelo mais caro. A seleção pode começar de outra forma quando a tarefa e os critérios estiverem bem delimitados.
Haiku 4.5: rapidez e tarefas delimitadas
A página do Haiku 4.5 o apresenta como opção rápida, com janela de contexto de 200 mil tokens. Janela de contexto é a capacidade de conteúdo que o modelo consegue considerar em uma interação, respeitadas as regras de entrada e saída. Os demais modelos desta comparação oferecem janela de um milhão de tokens, segundo suas páginas oficiais.
Eu avaliaria Haiku para classificar relatos de erro, resumir mudanças e explicar funções pequenas. O ganho pode ser relevante em trabalhos repetidos com resultado verificável. Isso não significa escolhê-lo automaticamente para uma função curta que calcula tributos ou concede acesso: poucas linhas podem carregar um risco alto.
Sonnet 5.5: trabalho cotidiano com contexto
A Anthropic posiciona Sonnet 5.5 como combinação de velocidade e capacidade. Para uma rotina de manutenção, eu o incluiria na avaliação de alterações delimitadas, revisão de código e criação de testes. Ele pode receber a função, seus chamadores e as regras relacionadas, em vez de trabalhar com um fragmento isolado.
Sua tarifa de saída é metade da de Opus 5.5. Entretanto, essa relação não prova que o trabalho completo custará metade: número de tentativas, conteúdo enviado e correções humanas alteram o resultado. A comparação útil utiliza a mesma demanda e verifica qual configuração entrega uma alteração aprovada.
Opus 5.5: investigação e programação em várias etapas
A documentação de Opus 5.5 destaca programação com agentes em sessões longas. Eu o testaria quando um defeito cruza camadas, quando a revisão exige relacionar vários módulos ou quando é preciso investigar antes de definir uma alteração.
O cuidado aqui é não confundir capacidade com autonomia irrestrita. Um diagnóstico bem elaborado ainda precisa ser confrontado com logs, execução e testes. Em projetos Delphi, a versão do compilador, os componentes e as convenções do repositório podem determinar se uma sugestão aparentemente correta é realmente utilizável.
Fable 5.1: problemas difíceis e de longa duração
Fable 5.1 tem foco em raciocínio exigente e trabalho prolongado com agentes. Eu o incluiria em investigações amplas, planejamento de migração ou tarefas em que a avaliação de alternativas seja parte importante do resultado, principalmente se opções anteriores falharem com contexto suficiente.
A página específica ainda menciona Opus 5 como ponto inicial, enquanto o catálogo atualizado indica Opus 5.5. Para a seleção atual, este artigo segue o catálogo mais recente; a diferença foi registrada na pesquisa. Essa divergência lembra por que consultar apenas um anúncio antigo não basta para recomendar um modelo.
Raciocínio e esforço não são a mesma configuração
A Anthropic usa “pensamento” (thinking) para o processamento de raciocínio do modelo e “esforço” (effort) para orientar a intensidade do trabalho. O esforço pode afetar explicações, chamadas de ferramentas e raciocínio. Não é uma reserva rígida de tokens. Para compreender a interação dos controles, consulte o guia de pensamento.
Haiku 4.5 oferece pensamento estendido, configurável com orçamento de tokens, mas não suporta o parâmetro de esforço usado pelos modelos atuais maiores. Fable 5.1 e Opus 5.5 usam pensamento adaptativo sempre ativo. Sonnet 5.5 possui regras próprias, incluindo pensamento entre ferramentas. Portanto, não copie a configuração de um modelo para outro supondo compatibilidade.
Na API, output_config.effort aceita os níveis documentados para o modelo. Opus 5.5 usa médio como padrão; Sonnet 5.5 e Fable 5.1 usam alto. A documentação de esforço recomenda avaliar níveis no próprio trabalho. As orientações práticas abaixo traduzem isso para demandas cotidianas:
- Baixo (
low): teste em pedidos simples e claros, nos quais rapidez importa e o resultado é fácil de conferir. Um resumo não precisa da mesma investigação de um defeito intermitente. - Médio (
medium): avalie em alterações especificadas, testes e manutenção com contexto. É um início útil para comparar custo e correção sem assumir que todo trabalho exige esforço elevado. - Alto (
high): compare quando existem relações entre módulos, hipóteses concorrentes ou consequências difíceis de antecipar. Exija evidências melhores, não apenas uma explicação maior. - Extra alto (
xhigh): considere em trabalhos longos e exigentes quando alto ainda deixa problemas demonstráveis. Defina o resultado esperado e acompanhe se o consumo adicional resolve essas falhas. - Máximo (
max): reserve para casos em que testes mostrem benefício suficiente. Se o modelo continua sem uma informação decisiva, mais esforço não substitui obter essa informação.
Esses rótulos não representam quantidades equivalentes de raciocínio entre fornecedores ou versões. No Claude Code, ultrathink é uma palavra reconhecida que acrescenta uma instrução para raciocinar mais profundamente naquele pedido; não altera o esforço enviado à API. A configuração oficial distingue esse recurso dos níveis de esforço. Não trate “ultra” como sinônimo automático de máximo.
Um guia de escolha por tarefa
Não há uma escada obrigatória entre os modelos. Primeiro considere dificuldade, clareza do pedido, risco do erro e custo de conferir o resultado. Depois compare configurações. Um modelo econômico pode atender bem a uma tarefa delimitada, enquanto uma investigação ambígua pode justificar avaliar maior capacidade desde o início.
| Tarefa | Configuração inicial para avaliação | Critério para comparar outra opção |
|---|---|---|
| Resumir alterações ou classificar chamados | Haiku, sem parâmetro de esforço | Perda de informações essenciais ou regras implícitas |
| Implementar alteração delimitada e testes | Sonnet com médio | Falhas entre módulos ou requisitos conflitantes |
| Revisar transação e integridade dos dados | Sonnet com alto; comparar Opus médio | Testes de falha continuam insuficientes |
| Diagnosticar defeito intermitente | Opus com médio ou alto | Hipóteses não explicam os registros disponíveis |
| Investigar migração ampla | Comparar Opus alto e Fable alto | Medir correção, cobertura, tempo e retrabalho |
Combinações editoriais para iniciar avaliações, não resultados de testes comparativos executados.
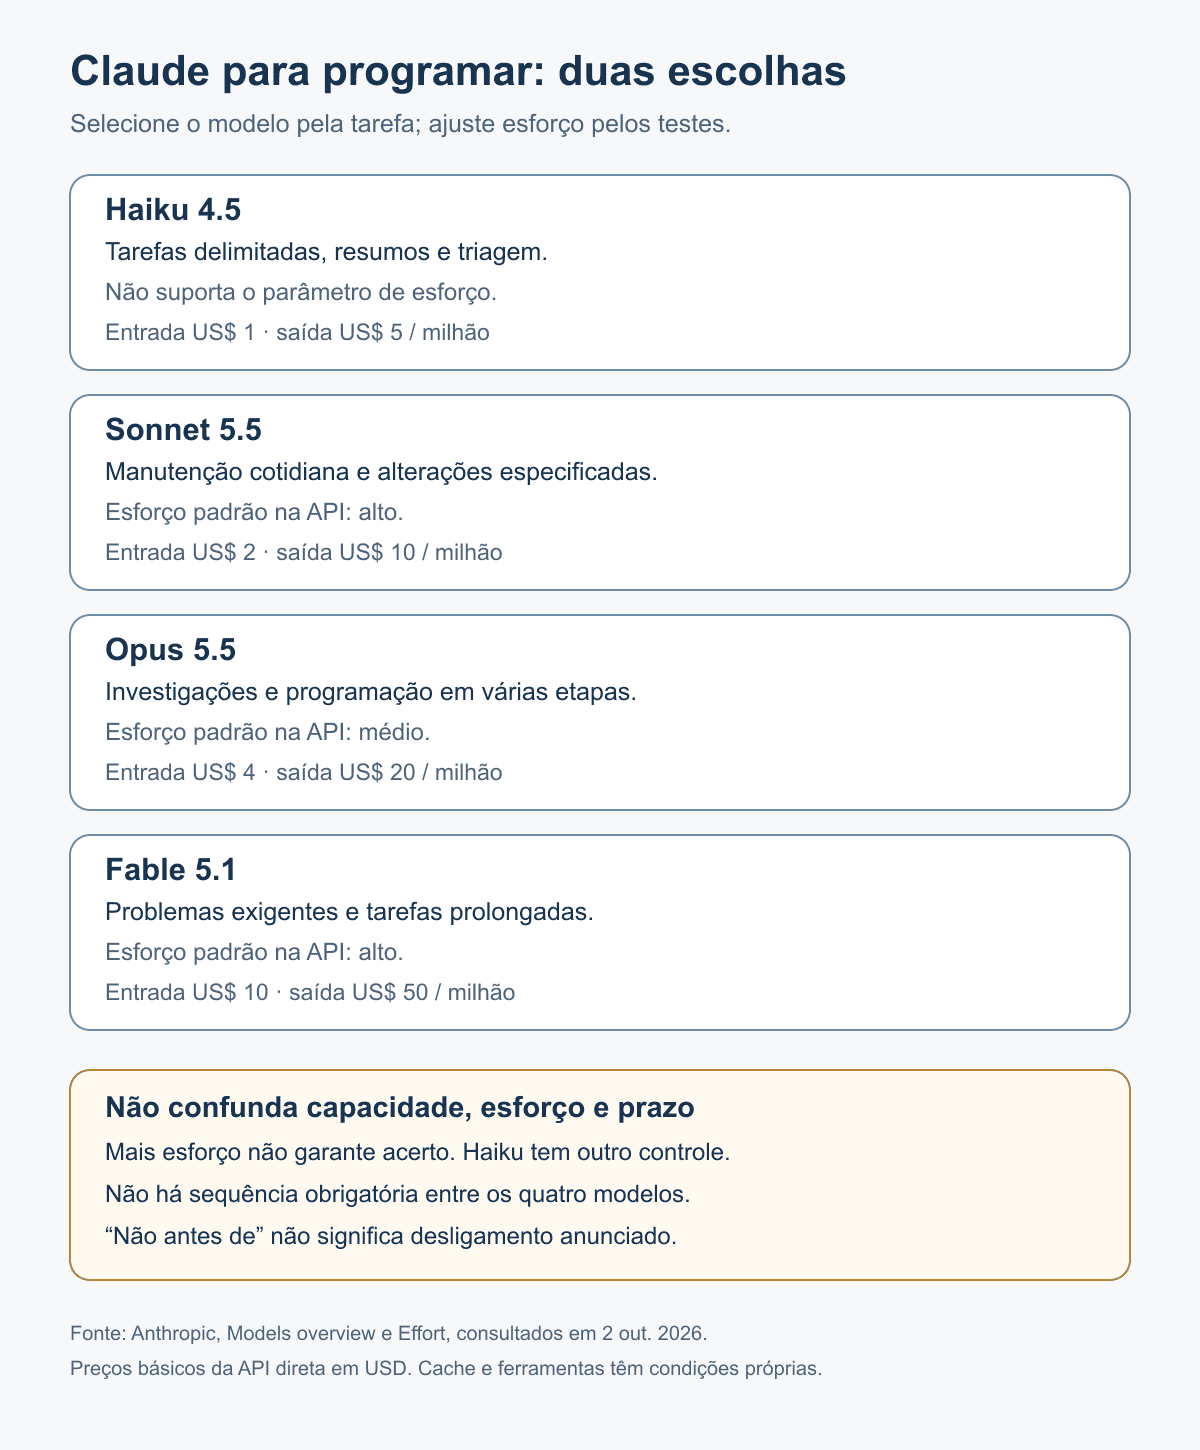
Fonte dos perfis: catálogo Anthropic. Controles: documentação de pensamento e esforço, consultada em 2 out. 2026.
Um exemplo aplicado ao desenvolvimento Delphi
Um pedido ao modelo, chamado prompt, deve informar ambiente, problema, limites e critérios de aprovação. Considere um sistema em que executar novamente uma importação pode duplicar pedidos. Idempotência significa que repetir a operação não produz uma duplicação indevida. Antes de pedir uma correção, descreva como identificar a operação e quais comportamentos precisam ser preservados.
O exemplo abaixo é uma especificação fictícia, não um diagnóstico realizado nem código testado. VCL é a biblioteca de interfaces Windows do Delphi; FireDAC é sua camada de acesso a dados. O objetivo é mostrar a organização do pedido, não fornecer uma solução pronta.
Ambiente: Delphi 12, VCL, FireDAC e PostgreSQL.
Problema: repetir a importação pode duplicar pedidos.
Vou fornecer a rotina, seus chamadores e registros sem dados pessoais.

Objetivo: tornar a importação idempotente.
Restrições: preservar regras de negócio e assinaturas públicas.
Não alterar o esquema do banco sem explicar necessidade e impacto.

Primeiro identifique informações ausentes e separe fatos de hipóteses.
Depois proponha a menor alteração e justifique as decisões.
Considere duas importações simultâneas e interrupção durante a gravação.
Liste testes para primeira execução, repetição, falha e concorrência.
Diferencie testes executados de testes apenas propostos.
Eu começaria com Sonnet e esforço médio se o fluxo estivesse bem especificado. Se duas operações simultâneas disputassem recursos — concorrência —, compararia alto e Opus. O teste decisivo não é a elegância da explicação: é verificar que repetição, falha e execução simultânea preservam a regra de negócio.
Para conectar essa abordagem ao ambiente de trabalho, veja a evolução do RadIA no desenvolvimento Delphi e os aprendizados sobre IA com Delphi, Lazarus e ACBr. A integração com ferramentas é útil, mas não substitui revisão da alteração.
Custo por chamada não é custo por solução
Considere, apenas para ilustrar a conta, uma chamada sem cache com 100 mil tokens de entrada e 20 mil de saída faturada. Pelas tarifas da tabela, custaria US$ 0,20 em Haiku, US$ 0,40 em Sonnet, US$ 0,80 em Opus e US$ 2,00 em Fable. Não é uma tarefa típica nem uma medição de desempenho; os 20 mil representam o total faturável, não só o texto visível.
O guia de pensamento esclarece que raciocínio é cobrado como saída mesmo quando não é exibido. max_tokens limita a saída total, incluindo pensamento; uma resposta interrompida pelo limite não deve ser tratada como trabalho concluído. Meça todas as chamadas, ferramentas e repetições até a aprovação.
Cache não torna o contexto gratuito: armazená-lo e reutilizá-lo têm preços diferentes. A modalidade de processamento em lote oferece desconto, mas não é equivalente a uma interação imediata. A página de preços detalha essas condições. Para orçar, utilize o modo efetivamente contratado e não generalize as tarifas da API direta para outros provedores.
Desligamento anunciado e prazo mínimo são coisas diferentes
A lista de descontinuações registra Sonnet 4.5, identificador claude-sonnet-4-5-20250929, como descontinuado em 30 de setembro de 2026, com desligamento em 30 de novembro de 2026 e substituição recomendada por claude-sonnet-5-5. Integrações existentes devem testar a migração antes desse prazo.
Haiku 4.5 continua ativo na consulta. A indicação “não antes de 15 de outubro de 2026” não anuncia retirada nessa data. O mesmo vale para os prazos mínimos dos demais modelos ativos. Já Opus 4.1, Opus 4 e Sonnet 4 aparecem como retirados; não devem ser confundidos com modelos disponíveis que ainda aguardam desligamento.
Outro detalhe evita migrações equivocadas: snapshot é uma versão fixa; alias é um nome que aponta para uma versão. A documentação de identificadores esclarece que, desde a geração 4.6, identificadores da API sem data são snapshots fixos, não atalhos que acompanham novidades. Os aliases do Claude Code têm regras próprias. Confira o nome efetivamente enviado pela integração e o provedor utilizado.
Como avaliar e lidar com uma resposta ruim
Monte um conjunto pequeno de tarefas reais sem segredos, mantendo as mesmas instruções e condições entre candidatos. Registre compilação, testes aprovados, regras preservadas, alterações desnecessárias, correções manuais, tempo e custo. Inclua casos difíceis, não apenas exemplos que todos resolvem. O guia de seleção da Anthropic recomenda avaliar a escolha no próprio uso.
Quando a resposta falhar, forneça o erro exato, o resultado esperado e o trecho relevante. Se aparecer uma função inexistente, peça uma referência compatível com a versão. Complete o contexto antes de aumentar esforço; compare outra configuração quando houver falhas verificáveis. Limite tentativas para não transformar uma hipótese fraca em uma sequência cara de respostas semelhantes.
Este artigo não apresenta um vencedor comprovado por testes independentes. Os perfis vêm do fornecedor; as combinações sugeridas são orientação editorial. Execute mudanças em ambiente controlado, restrinja permissões e revise código que afete dinheiro, segurança ou integridade de dados. Uma resposta confiante não é evidência de que uma regra fiscal foi corretamente implementada.
Conclusão
Escolher Claude para programar exige separar modelo, produto, pensamento e esforço. Haiku merece avaliação em tarefas delimitadas; Sonnet, na manutenção cotidiana; Opus, em trabalhos complexos com várias etapas; Fable, em problemas exigentes ou prolongados. Esses perfis orientam o teste, mas não determinam seu resultado.
A decisão deve considerar a alteração aceita, com todas as tentativas e revisões necessárias. Ajuste esforço com evidências, preserve contexto útil e confira as regras de compatibilidade antes de mudar configurações. Nas integrações existentes, planeje os desligamentos efetivamente anunciados, sem transformar prazos mínimos de disponibilidade em datas de retirada.
Quando a escolha de Claude já estiver encaminhada, vale fortalecer o que orienta seu trabalho: regras explícitas, contratos e critérios de aceite. SDD em Delphi aprofunda essa passagem da demanda para uma implementação verificável, sem depender de um fornecedor específico. Confira o sumário e a degustação gratuita para avaliar se esse é o próximo passo útil para seu projeto.
Referências
ANTHROPIC. Choosing the right model. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/about-claude/models/choosing-a-model. Acesso em: 2 out. 2026.
ANTHROPIC. Claude Fable 5.1. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/models/fable-5-1/overview. Acesso em: 2 out. 2026.
ANTHROPIC. Claude Haiku 4.5. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/models/haiku-4-5/overview. Acesso em: 2 out. 2026.
ANTHROPIC. Claude Opus 5.5. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/models/opus-5-5/overview. Acesso em: 2 out. 2026.
ANTHROPIC. Claude Sonnet 5.5. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/models/sonnet-5-5/overview. Acesso em: 2 out. 2026.
ANTHROPIC. Effort. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/build-with-claude/effort. Acesso em: 2 out. 2026.
ANTHROPIC. Model configuration. Claude Code Docs, [s. d.]. Disponível em: https://code.claude.com/docs/en/model-config. Acesso em: 2 out. 2026.
ANTHROPIC. Model deprecations. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/about-claude/model-deprecations. Acesso em: 2 out. 2026.
ANTHROPIC. Model IDs and versioning. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/about-claude/models/model-ids-and-versions. Acesso em: 2 out. 2026.
ANTHROPIC. Models overview. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/models/overview. Acesso em: 2 out. 2026.
ANTHROPIC. Pricing. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/about-claude/pricing. Acesso em: 2 out. 2026.
ANTHROPIC. Thinking. Claude Platform Docs, [s. d.]. Disponível em: https://platform.claude.com/docs/en/build-with-claude/thinking. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. IA na prática com Delphi, Lazarus e ACBr: aprendizados do Papo Pro. Régys Borges da Silveira, [s. d.]. Disponível em: https://regys.com.br/ia-na-pratica-com-delphi-lazarus-e-acbr-aprendizados-do-papo-pro/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. RadIA 2.17.18: o que mudou desde a versão 2.15 e como a comunidade ajudou o projeto a evoluir. Régys Borges da Silveira, 2 out. 2026. Disponível em: https://regys.com.br/radia-2-17-18-evolucao-desde-versao-2-15/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. SDD em Delphi. 1. ed. 2026. Disponível em: https://livros.regys.com.br/sdd-em-delphi. Acesso em: 3 out. 2026.
Descubra mais sobre Régys Borges da Silveira
Assine para receber nossas notícias mais recentes por e-mail.

Dê-nos sua opinião, seu comentário ajuda o site a crescer e melhorar a qualidade dos artigos.