
Depois de analisar os modelos da OpenAI, da Anthropic e do Google, vale ampliar o mapa. DeepSeek, Qwen, Mistral, Kimi e GLM oferecem caminhos que merecem avaliação quando o problema é manter software, revisar código ou automatizar uma atividade repetitiva.
“Menos usados” depende do público, da ferramenta e da região. Sem dados comparáveis de adoção, não seria correto transformar essa percepção em um ranking. Neste penúltimo artigo da série, o recorte são alternativas fora do trio já discutido, não modelos inferiores nem substitutos obrigatórios.
A pesquisa foi realizada em 2 de outubro de 2026. O objetivo é explicar diferenças práticas, preços de APIs, controles de raciocínio e cuidados com integração e execução própria. As aplicações sugeridas são critérios editoriais para experimentação: este artigo não apresenta um teste comparativo de desempenho em Delphi.
A troca de fornecedor não elimina as decisões sobre dados, ferramentas, permissões e avaliação. IA Além da Conversa aprofunda essas camadas e ajuda a estudar a arquitetura que permanece necessária, qualquer que seja o modelo escolhido. Conheça a proposta e leia a degustação gratuita para avaliar esse percurso. Se o interesse é compreender o funcionamento interno, Do Zero ao LLM com Delphi apresenta treinamento e geração em um laboratório educacional em Object Pascal, não uma alternativa pronta para substituir serviços comerciais.
O que realmente está sendo escolhido
Um modelo de linguagem processa informações e produz respostas. A API, interface de programação de aplicações, é o meio pelo qual um software solicita esse processamento. Já um agente é um programa que pode pedir ações a ferramentas, receber resultados e continuar trabalhando. Modelo, agente e editor não são a mesma coisa.
Contexto é o conjunto de informações disponível na solicitação: instruções, código, documentos e registros de erro. Tokens são unidades de processamento desse material, não uma contagem direta de palavras ou linhas. Raciocínio é o processamento intermediário realizado antes da resposta final; seus controles variam entre modelos e serviços.
Também existe uma diferença entre contratar uma API hospedada e executar um modelo por conta própria. Pesos são os valores numéricos aprendidos pelo modelo. Quando eles estão disponíveis para download, fala-se em pesos abertos (open weights). Isso não significa, por si só, acesso a todos os dados de treinamento nem ausência de condições de licença.
Na execução própria, a equipe passa a cuidar de infraestrutura, atualizações e proteção do serviço. Na API hospedada, precisa avaliar cobrança, tratamento de dados, disponibilidade e limites do fornecedor. Portanto, o nome do modelo é apenas uma parte da decisão; a forma de acesso pode mudar o que ele efetivamente oferece.
DeepSeek: separar a versão do nome usado na API
A documentação atual de modelos e preços apresenta deepseek-flash, atendido pelo DeepSeek-V4.1-Flash, e deepseek-v4-pro, associado ao DeepSeek-V4-Pro-0813. Ambos admitem processamento com e sem raciocínio. Não escolha a API apenas por um tutorial antigo que menciona outra geração.
Eu avaliaria Flash para explicações, manutenção delimitada e primeiras tentativas de revisão; Pro entraria como alternativa para investigações que exigem comparar hipóteses. É uma proposta de distribuição de trabalho, não a afirmação de que Pro sempre encontrará um defeito que Flash não encontra.
Um detalhe importante aparece no guia de raciocínio: os esforços efetivos são baixo (low), alto (high) e máximo (max). Valores recebidos como médio (medium) são remapeados para alto; ultra é remapeado para máximo. Uma interface com muitos rótulos não garante muitos níveis distintos no processamento.
O raciocínio vem ativado por padrão, com esforço alto. Para tarefas simples, teste a opção sem raciocínio ou baixo; para análise com consequências relevantes, compare alto e máximo. A configuração deve acompanhar a dificuldade observada, sem transformar máximo em escolha automática para qualquer solicitação.
Qwen: pesos disponíveis não garantem recursos no serviço
O Qwen3-Coder-Next é um modelo voltado a código, com pesos publicados sob Apache 2.0. Sua ficha informa 80 bilhões de parâmetros totais, com 3 bilhões ativados, e apenas modo sem raciocínio explícito. Não presuma que o número de parâmetros ativados representa todo o tamanho necessário para armazená-lo.
Esse caminho merece atenção de equipes que desejam experimentar execução própria ou comparar uma alternativa especializada. Antes de comprar hardware, avalie memória, contexto utilizado, velocidade e concorrência. Disponibilidade dos pesos não é promessa de que o modelo completo funcionará confortavelmente em qualquer computador de desenvolvimento.
Há uma diferença que merece cuidado: o material do modelo descreve uso com ferramentas, enquanto a ficha do serviço Alibaba Cloud Model Studio marca chamada de funções como não suportada. Chamada de funções é o mecanismo pelo qual o modelo solicita a execução de uma operação descrita pelo aplicativo.
Não esconda essa divergência tratando capacidade do modelo e disponibilidade na API como equivalentes. Para leitura de código, o serviço pode ser uma opção de avaliação; para um agente que precisa acionar ferramentas, confirme a implementação efetivamente disponível no ambiente escolhido antes de migrar.
Mistral: assistência geral e preenchimento de código
O Mistral Small 4 combina instruções, raciocínio e código. A ficha consultada o apresenta em disponibilidade geral, com pesos sob Apache 2.0 e identificador mistral-small-2603. Eu o incluiria na avaliação de documentação, revisão delimitada e tarefas frequentes em que custo e tempo de resposta importam.
Já o Codestral 25.08, identificado por codestral-2508, é especializado em completar código, incluindo preencher um trecho entre partes existentes (fill-in-the-middle, ou FIM). Esse uso é diferente de investigar todo um sistema: o editor fornece o trecho anterior e posterior para orientar a continuação.
A escolha prática começa pela interação desejada. Quem procura sugestões durante a digitação deve avaliar preenchimento e integração com o editor; quem precisa discutir alternativas arquiteturais deve avaliar uma interação de análise. Nem todo modelo de código foi desenhado para a mesma forma de colaboração.
No guia de raciocínio da Mistral, o Small é usado em exemplos com reasoning_effort: high inclui conteúdo de raciocínio, enquanto none o omite e usa pensamento mínimo. O nome none não deve ser interpretado como uma garantia universal de ausência completa de processamento intermediário.
Kimi e GLM: atenção ao raciocínio obrigatório
A documentação do Kimi K2.7 Code o apresenta como opção dedicada à programação, com identificador kimi-k2.7-code. O Kimi K3, identificado por kimi-k3, amplia o foco para engenharia de software e trabalho de longo percurso.
No K2.7 Code, desativar o raciocínio provoca erro. No K3, ele também permanece sempre ativo, com esforços baixo, alto e máximo, sendo máximo o padrão, conforme o guia específico de esforço. Não reutilize a configuração de um modelo anterior supondo que todos aceitam um interruptor para desligá-lo.
Eu avaliaria K2.7 Code em manutenção com várias etapas e K3 em tarefas que precisam sustentar uma análise mais extensa. Antes disso, verificaria o consumo e o comportamento da integração. A possibilidade de reduzir esforço é diferente de eliminar o raciocínio, distinção relevante para latência e orçamento.
O GLM-5.3, da Z.ai, também mantém raciocínio obrigatório. Seu identificador é glm-5.3, com low, high e max, sendo máximo o padrão. A documentação avisa que a configuração thinking.type: "disabled" precisa ser alterada antes da migração, ou a solicitação falhará.
O fornecedor destaca engenharia de software e agentes, mas isso não demonstra domínio de todo sistema Delphi. Eu o colocaria na mesma avaliação de defeitos e alterações complexas usada para os demais candidatos. A resposta deve explicar o código recebido, respeitar restrições e produzir uma mudança que possa ser conferida.
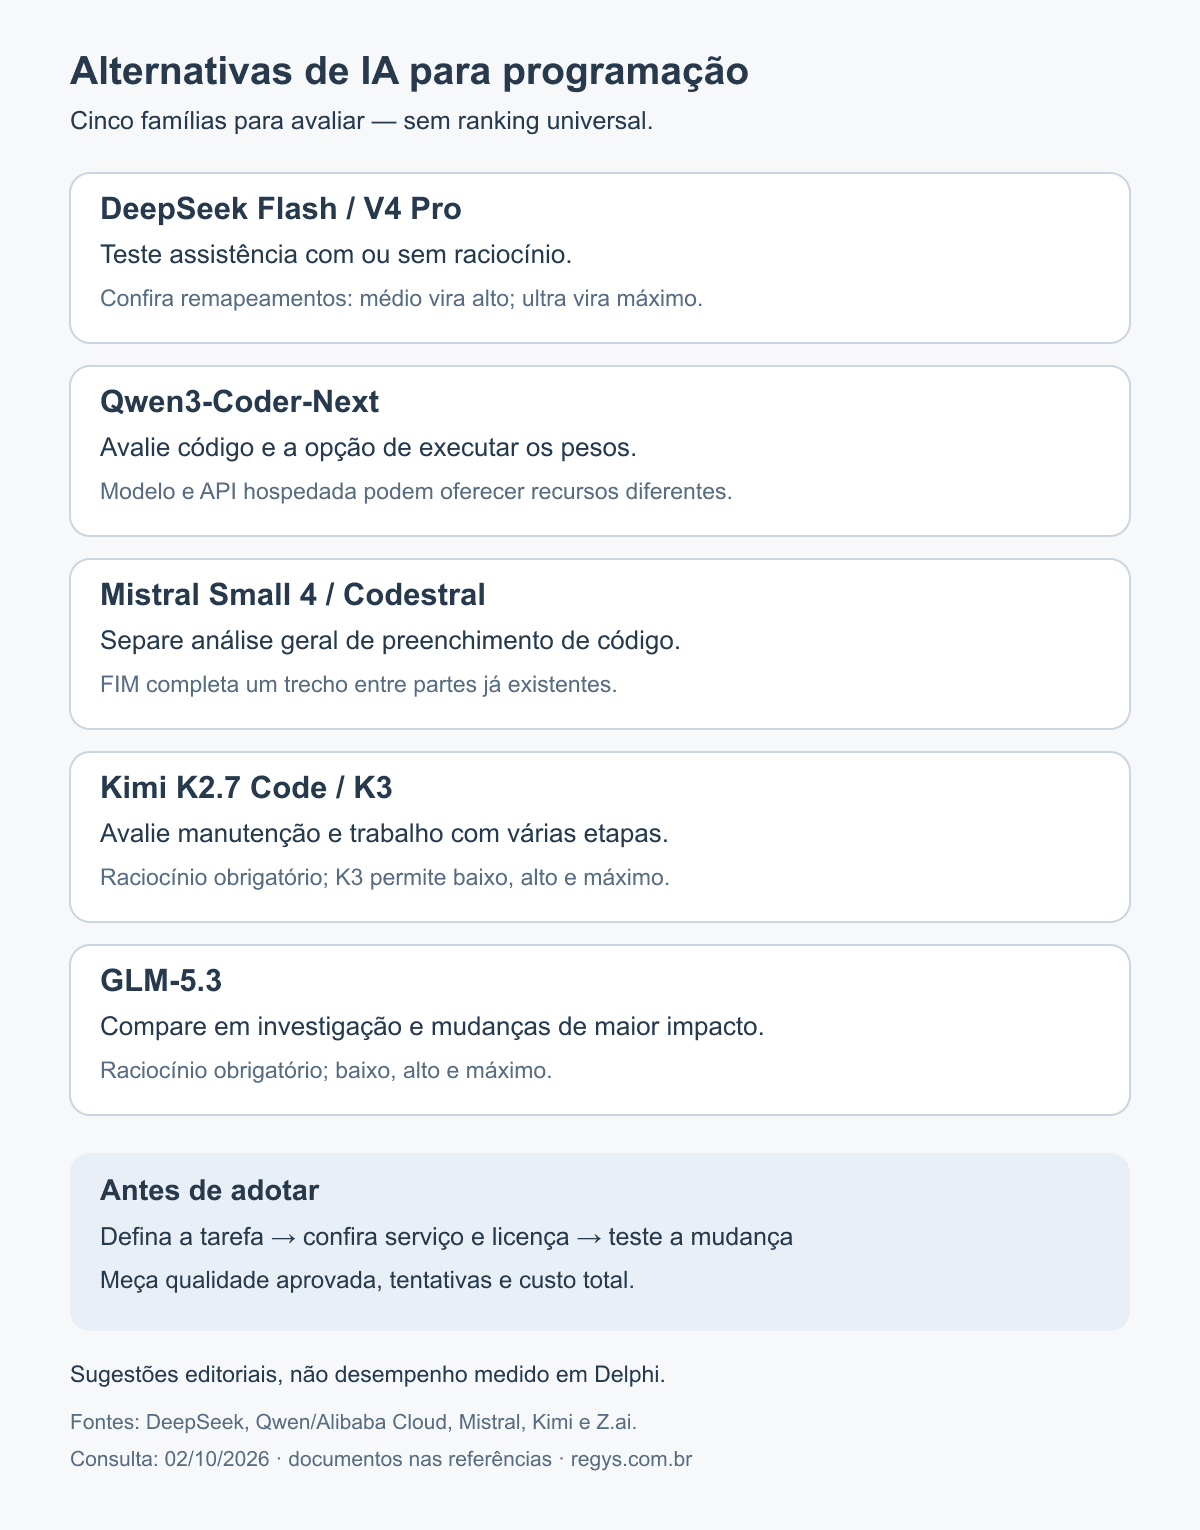
Mapa de avaliação editorial, não ranking de desempenho. Fontes: documentação oficial de DeepSeek, Qwen, Alibaba Cloud, Mistral, Kimi e Z.ai, listada nas referências. Consulta em 2 out. 2026.
Preços: compare o serviço e as condições, não só a marca
Os valores abaixo são em dólares por um milhão de tokens de entrada sem cache e de saída, nessa ordem. Cache é a reutilização de conteúdo já processado, com regras e tarifas próprias. O recorte é API paga, não assinatura de aplicativo ou plano de programação.
- DeepSeek Flash: US$ 0,30 / US$ 1,20 no período de pico; fora dele, US$ 0,15 / US$ 0,60.
- DeepSeek V4 Pro: US$ 1,32 / US$ 3,96 no pico; fora dele, US$ 0,66 / US$ 1,98. Os períodos seguem o calendário e os horários UTC descritos na tabela da DeepSeek, não um calendário brasileiro presumido.
- Qwen3-Coder-Next no Model Studio de Singapura, escopo internacional: US$ 0,30 / US$ 1,50 até 32 mil tokens de entrada; US$ 0,50 / US$ 2,50 acima de 32 mil até 128 mil; US$ 0,80 / US$ 4,00 acima de 128 mil até 256 mil, conforme a ficha do serviço.
- Mistral Small 4: US$ 0,15 / US$ 0,60. Codestral: US$ 0,30 / US$ 0,90, na modalidade padrão da tabela Mistral.
- Kimi K2.7 Code: US$ 0,95 / US$ 4,00. Kimi K3: US$ 3,00 / US$ 15,00, além das cobranças específicas de escrita em cache, segundo a tabela Kimi.
- GLM-5.3 na Z.ai: US$ 1,40 / US$ 4,40, conforme a tabela Z.ai. O plano de programação por assinatura é outra contratação.
Em um cálculo hipotético com 20 mil tokens de entrada e 5 mil de saída faturável, Flash no pico custa US$ 0,012; Qwen na primeira faixa custa US$ 0,0135. O cálculo considera somente essas tarifas, sem impostos, câmbio, ferramentas ou outros itens. Não é uma medida de qualidade nem de consumo típico.
O indicador útil é o custo da tarefa aprovada: solicitações, tentativas, processamento e tempo humano de revisão. Modelos diferentes podem consumir quantidades distintas para resolver o mesmo problema. Uma comparação com a mesma quantidade de tokens facilita a aritmética, mas não demonstra qual solução será mais econômica em produção.
Aplicação prática: um teste pequeno antes de trocar a ferramenta
Monte uma avaliação com tarefas representativas: explicar uma unidade, corrigir um defeito reproduzível, propor testes e revisar uma alteração. Forneça o mesmo contexto a cada candidato e defina o que será considerado correto antes de ler as respostas. Sem isso, eloquência pode acabar confundida com qualidade.
Para Delphi, escolha um caso em que o comportamento esperado possa ser demonstrado. Uma falha causada pela interpretação de separadores decimais é um exemplo útil porque obriga a distinguir formato do arquivo, configuração regional e regra do sistema. A instrução abaixo é ilustrativa; não foi executada em modelos nem validada por compilador.
Projeto: Delphi 12, Object Pascal.
Problema: a importação de valores decimais muda de comportamento
entre computadores com configurações regionais diferentes.

Vou fornecer a rotina, o formato documentado do arquivo,
entradas de exemplo e resultados esperados.

Identifique dependências da configuração regional.
Proponha a menor alteração que preserve o formato do arquivo.
Não invente regras para separadores ambíguos.
Sugira testes para valores válidos, inválidos e campos vazios.
Informe o que não pode concluir com o material recebido.
Comece com processamento simples ou esforço baixo, quando disponível. Aumente o esforço se a tarefa envolver hipóteses concorrentes ou consequências difíceis de avaliar. Depois, compile, execute os testes e revise a mudança. Não aumente esforço para compensar a ausência da especificação do arquivo.
Registre modelo, serviço, configuração, consumo, tempo e resultado aprovado. Confira também se a integração preserva mensagens e respostas de ferramentas conforme a documentação do fornecedor. Uma API com formato compatível não garante comportamento idêntico; adaptar só o endereço pode ser insuficiente.
Limitações, privacidade e ciclo de vida
Para código proprietário, verifique contrato, política de dados, região de processamento e permissões. Na execução própria, revise também conexões externas, registros e acesso ao servidor. Manter pesos localmente não prova que todas as ferramentas usadas ao redor deles funcionam sem transmitir dados.
A vantagem potencial das alternativas é ampliar opções de custo, especialização e controle operacional. A contrapartida é avaliar integração, licença, suporte e manutenção. Trocar um fornecedor conhecido por outro sem testar essas condições pode apenas transferir o problema de lugar.
Há mudanças documentadas que tornam tutoriais antigos arriscados. Na DeepSeek, os nomes legados deepseek-v4-flash e deepseek-v4-flash-vision-exp continuam aceitos, mas são atendidos pelo V4.1-Flash e cobrados pela tarifa atual. Aceitar uma identificação antiga não significa preservar o modelo antigo.
No Kimi, a lista de modelos registra a descontinuação de K2.5 e da família moonshot-v1 em 31 de agosto de 2026, e da série K2 em 25 de maio de 2026. Não confunda essas versões com K2.7 Code.
A política da Mistral distingue descontinuação anunciada de retirada efetiva e informa aviso de seis meses para modelos de disponibilidade geral, contra um mês para modelos de terceiros. Ausência de data em uma ficha não é promessa de manutenção permanente: acompanhe o serviço contratado e preserve testes de migração.
Conclusão
DeepSeek, Qwen, Mistral, Kimi e GLM ampliam o conjunto de ferramentas possíveis, mas não formam uma categoria homogênea. Há diferenças entre análise e preenchimento de código, raciocínio ajustável e obrigatório, pesos disponíveis e funcionalidades entregues pela API.
A recomendação prática é avaliar poucos candidatos com tarefas reais e critérios explícitos. Escolha pelo resultado verificável, pelo custo completo e pela capacidade de operar a integração com segurança. Uma alternativa vale a adoção quando resolve melhor uma necessidade concreta, não apenas porque seu nome apareceu menos nas conversas anteriores.
Depois de comparar alternativas, a questão passa a ser como manter a solução útil quando modelos e serviços mudarem. IA Além da Conversa aprofunda a arquitetura de contexto, ferramentas, avaliação e operação. Consulte o sumário e a degustação gratuita para avaliar essa leitura; compreender os mecanismos de uma rede neural, por outro lado, é o objetivo distinto do laboratório educacional apresentado na abertura.
Referências
ALIBABA CLOUD. qwen3-coder-next. Alibaba Cloud Model Studio, 28 set. 2026. Disponível em: https://www.alibabacloud.com/help/en/model-studio/qwen3-coder-next. Acesso em: 2 out. 2026.
DEEPSEEK. Models & Pricing. DeepSeek API Docs, [s. d.]. Disponível em: https://api-docs.deepseek.com/quick_start/pricing/. Acesso em: 2 out. 2026.
DEEPSEEK. Thinking Mode. DeepSeek API Docs, [s. d.]. Disponível em: https://api-docs.deepseek.com/guides/thinking_mode/. Acesso em: 2 out. 2026.
MISTRAL AI. Codestral. Mistral Docs, 30 jul. 2025. Disponível em: https://docs.mistral.ai/models/codestral-25-08. Acesso em: 2 out. 2026.
MISTRAL AI. Mistral Small 4. Mistral Docs, 16 mar. 2026. Disponível em: https://docs.mistral.ai/models/mistral-small-4-0-26-03. Acesso em: 2 out. 2026.
MISTRAL AI. Model lifecycle policy. Mistral Docs, [s. d.]. Disponível em: https://docs.mistral.ai/inference/model-lifecycle. Acesso em: 2 out. 2026.
MISTRAL AI. Pricing. Mistral Docs, [s. d.]. Disponível em: https://docs.mistral.ai/inference/pricing. Acesso em: 2 out. 2026.
MISTRAL AI. Reasoning. Mistral Docs, [s. d.]. Disponível em: https://docs.mistral.ai/studio/conversations/reasoning. Acesso em: 2 out. 2026.
MOONSHOT AI. Kimi K2.7 Code. Kimi API Platform, [s. d.]. Disponível em: https://platform.kimi.ai/docs/guide/kimi-k2-7-code-quickstart. Acesso em: 2 out. 2026.
MOONSHOT AI. Kimi K3. Kimi API Platform, [s. d.]. Disponível em: https://platform.kimi.ai/docs/guide/kimi-k3-quickstart. Acesso em: 2 out. 2026.
MOONSHOT AI. Model Inference Pricing Explanation. Kimi API Platform, [s. d.]. Disponível em: https://platform.kimi.ai/docs/pricing/chat. Acesso em: 2 out. 2026.
MOONSHOT AI. Model List. Kimi API Platform, [s. d.]. Disponível em: https://platform.kimi.ai/docs/models. Acesso em: 2 out. 2026.
MOONSHOT AI. Reasoning Effort. Kimi API Platform, [s. d.]. Disponível em: https://platform.kimi.ai/docs/guide/use-reasoning-effort. Acesso em: 2 out. 2026.
QWEN TEAM. Qwen3-Coder-Next. Hugging Face, [s. d.]. Disponível em: https://huggingface.co/Qwen/Qwen3-Coder-Next. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Do Zero ao LLM com Delphi. 1. ed. 2026. Disponível em: https://livros.regys.com.br/do-zero-ao-llm-com-delphi. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. Modelos da Anthropic para programação: preços, raciocínio e quando usar cada Claude. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/modelos-da-anthropic-para-programacao-precos-raciocinio-e-quando-usar-cada-claude/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Modelos da OpenAI para programação: comparação, preços e quando usar cada um. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/modelos-da-openai-para-programacao-comparacao-precos-e-quando-usar-cada-um/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Modelos Gemini para programação: preços, raciocínio e quando usar cada um. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/modelos-gemini-para-programacao-precos-raciocinio-e-quando-usar-cada-um/. Acesso em: 2 out. 2026.
Z.AI. GLM-5.3. Z.AI Developer Document, [s. d.]. Disponível em: https://docs.z.ai/guides/llm/glm-5.3. Acesso em: 2 out. 2026.
Z.AI. Pricing. Z.AI Developer Document, [s. d.]. Disponível em: https://docs.z.ai/guides/overview/pricing. Acesso em: 2 out. 2026.
Descubra mais sobre Régys Borges da Silveira
Assine para receber nossas notícias mais recentes por e-mail.


Dê-nos sua opinião, seu comentário ajuda o site a crescer e melhorar a qualidade dos artigos.