

Escolher um modelo de inteligência artificial para programar parece simples até aparecer a conta — ou até o modelo mais barato errar uma alteração delicada. O nome mais novo nem sempre é o melhor para toda tarefa, assim como o maior preço por token não garante o menor custo por solução concluída. E há uma confusão comum: assinatura do ChatGPT ou do Codex não é a mesma coisa que cobrança pela API.
Neste guia, comparo os modelos gerais que a OpenAI apresenta como opções atuais de referência — GPT-6 Astra, GPT-6.1 Sol e GPT-6 Luna — pela perspectiva de quem escreve, revisa, explica e automatiza software. Também explico o que fazer com o GPT-5.3-Codex, que aparece em conversas e artigos recentes, mas foi descontinuado. Os preços são os publicados para a API em 2 de outubro de 2026; confira a página oficial antes de adotar um orçamento, pois modelos e tarifas mudam.
Escolher o modelo é apenas uma parte do trabalho. Para estudar como contexto, dados, ferramentas, permissões, avaliação e custos se combinam em uma solução operável, conheça IA Além da Conversa e leia a degustação gratuita na página do livro. Se o desafio é orientar as alterações de código com requisitos e critérios de aceite, SDD em Delphi oferece um percurso complementar. Essas leituras aprofundam o método, não indicam um fornecedor vencedor.
Antes de comparar: o que exatamente está sendo cobrado?
Antes dos preços, separe três conceitos. O modelo interpreta o pedido e produz uma resposta; o produto, como ChatGPT ou Codex, é o ambiente pelo qual você trabalha; o esforço de raciocínio é uma configuração disponível em determinados modelos para orientar quanto trabalho dedicar à tarefa. Usar Codex não significa necessariamente usar um modelo cujo nome contém “Codex”.
O ambiente integrado de desenvolvimento (IDE) reúne ferramentas para construir software. Um agente combina o modelo com ferramentas e um fluxo de execução, que pode fornecer arquivos, permissões e testes. A aprovação da alteração continua dependendo de critérios verificáveis e revisão humana.
Este artigo se concentra nos modelos gerais de texto relevantes para programação pela API — a interface que um sistema usa para enviar entradas e receber respostas. A cobrança variável depende dos tokens: unidades de texto, pontuação ou código que não correspondem exatamente a palavras. A tabela distingue entrada, entrada em cache (contexto repetido com preço reduzido quando aplicável) e saída produzida pelo modelo.
ChatGPT e Codex podem ter limites e cobrança próprios. Portanto, preço por token não é mensalidade nem custo total de usar esses produtos; disponibilidade e ferramentas também variam. Consulte o catálogo de modelos e a página de preços da API, sem presumir que nomes ou limites se aplicam igualmente a API e ChatGPT.
Os modelos gerais atuais, vistos por quem programa
| Modelo | Entrada padrão / em cache / saída por 1 milhão de tokens | Melhor ponto de partida em programação |
|---|---|---|
GPT-6 Astra (gpt-6-astra) | US$ 10 / US$ 1 / US$ 50 | Problemas difíceis, requisitos ambíguos, diagnóstico profundo e fluxos longos com ferramentas |
GPT-6.1 Sol (gpt-6.1-sol) | US$ 2 / US$ 0,10 / US$ 10 | Trabalho complexo recorrente quando se busca capacidade alta com custo menor que Astra |
GPT-6 Luna (gpt-6-luna) | US$ 0,10 / US$ 0,01 / US$ 0,50 | Tarefas bem delimitadas e frequentes, triagem e processamento em volume |
Deslize a tabela para os lados para ver todas as colunas.
Valores em dólares por milhão de tokens, no processamento Standard e até 272 mil tokens de entrada. Outros modos, ferramentas, impostos e câmbio não estão incluídos. Fonte: preços oficiais, consultados em 2 out. 2026.
Onde eles entram na rotina de desenvolvimento?
Entender código legado, localizar a causa de um teste que falhou, implementar uma demanda e revisar mudanças exigem combinações diferentes de modelo e raciocínio. Um diff mostra as diferenças entre versões; o modelo pode resumi-lo, levantar riscos e sugerir testes. A equipe verifica os resultados e aprova a alteração. Em Delphi ou outra base empresarial, informe versão, convenções e limites do código que pode ser modificado. A tabela prática adiante combina essas tarefas com pontos iniciais de avaliação.
GPT-6 Astra: quando a tarefa é difícil de especificar
Astra é apresentado pela OpenAI como o modelo mais capaz para trabalho exigente, incluindo raciocínio complexo e programação. Para uma equipe, isso o torna um candidato a investigar bugs que atravessam camadas, compreender uma base de código extensa, ponderar alternativas de arquitetura ou conduzir uma mudança de várias etapas com ferramentas. É também o modelo mais caro dos três na tarifa por token: a saída custa cinco vezes mais que a do Sol e cem vezes mais que a do Luna, segundo os preços padrão publicados.
Não encaminhe automaticamente todo pedido para Astra. Tarefas claras e pequenas talvez não aproveitem sua capacidade extra. Preço por token também não é custo por tarefa: compare tentativas, resultado e retrabalho no seu fluxo. A OpenAI sugere Astra como início para geração de código via API, mas recomenda testar casos representativos antes de padronizar (catálogo; guia de código).
GPT-6.1 Sol: o equilíbrio para desenvolvimento cotidiano complexo
Sol é um candidato para desenvolvimento complexo recorrente com controle de custos. A documentação descreve GPT-6.1 Sol como próximo de Astra em tarefas complexas, com custo menor. A versão 6.1 foi lançada em 29 de setembro de 2026, conforme o guia de modelos e o registro de atualizações. Esse posicionamento do fornecedor não substitui uma comparação no seu projeto.
Eu o avaliaria para revisar propostas de alteração no repositório (pull requests), implementar demandas, criar testes e depurar com contexto de projeto. “Próximo de Astra” é a caracterização da OpenAI; compare os dois na mesma tarefa e meça correção, tempo, retrabalho e custo.
GPT-6 Luna: volume e tarefas de escopo menor
Luna é a opção mais econômica da família apresentada pela OpenAI para tarefas focadas e de alto volume. Isso sugere usos como classificar relatos de erro, extrair dados de chamados de suporte, resumir alterações, explicar trechos pequenos ou fazer uma primeira triagem — especialmente quando o sistema consegue encaminhar os casos difíceis para outro modelo.
O preço baixo não faz de Luna a escolha automática para refatorações arriscadas ou defeitos que cruzam o sistema. Uma aplicação pode iniciar nele e comparar outro modelo se os critérios de qualidade não forem atendidos. Isso é uma estratégia de avaliação, não uma sequência obrigatória nem garantia de economia.
Qual nível de raciocínio usar no dia a dia?
Além do modelo, a API permite ajustar o esforço de raciocínio por reasoning.effort. Esse parâmetro orienta quanto trabalho dedicar à tarefa. Valores maiores podem ajudar em planejamento e depuração, mas tendem a elevar a latência — o tempo de resposta — e o consumo de tokens internos, faturados como saída. Modelo e esforço são escolhas distintas: mais esforço não garante acerto.
low(baixo): comece aqui para explicar uma função, sugerir uma alteração direta, gerar um teste simples ou corrigir uma falha localizada. É uma escolha útil quando rapidez e custo pesam e os critérios estão claros.medium(médio): ponto inicial equilibrado para muita programação diária: depurar com logs, implementar uma demanda com contexto, escrever testes ou revisar um diff. GPT-6.1 Sol e Luna usam médio como padrão documentado; confirme o padrão do modelo escolhido.high(alto): experimente para um defeito difícil, efeito colateral entre módulos, migração ou decisão técnica de maior impacto. Compare com médio e mantenha alto se a redução de erros e retrabalho justificar tokens e espera extras.xhigh(extra alto): apropriado para fluxos mais longos ou desafiadores, como revisão de segurança, agente com várias etapas ou migração complexa, quando testes representativos demonstrarem benefício.max(máximo): reserve às tarefas mais complexas e sensíveis à qualidade; compare comxhigh. O nível máximo não garante acerto e não deve ser o padrão de cada chamada.
Luna também aceita none, que desativa o esforço de raciocínio; Astra e GPT-6.1 Sol não aceitam essa opção, e GPT-6.1 Sol também não aceita minimal. Os valores dependem do modelo, conforme a documentação de raciocínio.
E “ultra”? Não é um valor de reasoning.effort nessa documentação da API. Não confunda rótulos de interfaces com parâmetros de integração: confira o produto utilizado. Ultrafast é um modo de serviço, enquanto o modo de raciocínio Pro é outro controle, independente do esforço; nenhum deles equivale ao nível máximo nem à assinatura Pro do ChatGPT.
Consulta rápida: tarefa, modelo e esforço
Estas combinações são sugestões editoriais para iniciar testes, baseadas nos perfis documentados pela OpenAI. Eleve o esforço ou troque o modelo quando resultados verificáveis indicarem necessidade. O tamanho do arquivo não determina dificuldade ou risco: uma função curta pode calcular tributos, conceder permissões ou comprometer dados.
| Tarefa cotidiana | Começar com | Quando comparar uma opção mais exigente |
|---|---|---|
| Explicar uma função ou resumir alterações | Luna + baixo | Quando depender de vários arquivos ou regras implícitas |
| Implementar alteração delimitada e seus testes | Sol + médio | Quando cruzar módulos ou revelar requisitos conflitantes |
| Revisar uma proposta de alteração | Sol + médio | Alto para riscos importantes; extra alto se houver benefício medido |
| Investigar defeito difícil ou intermitente | Sol + alto | Astra + alto se o diagnóstico continuar inconclusivo |
| Planejar refatoração ampla ou migração | Astra + alto | Extra alto ou máximo se melhorarem o resultado nos testes |
Deslize a tabela para os lados para ver todas as colunas.
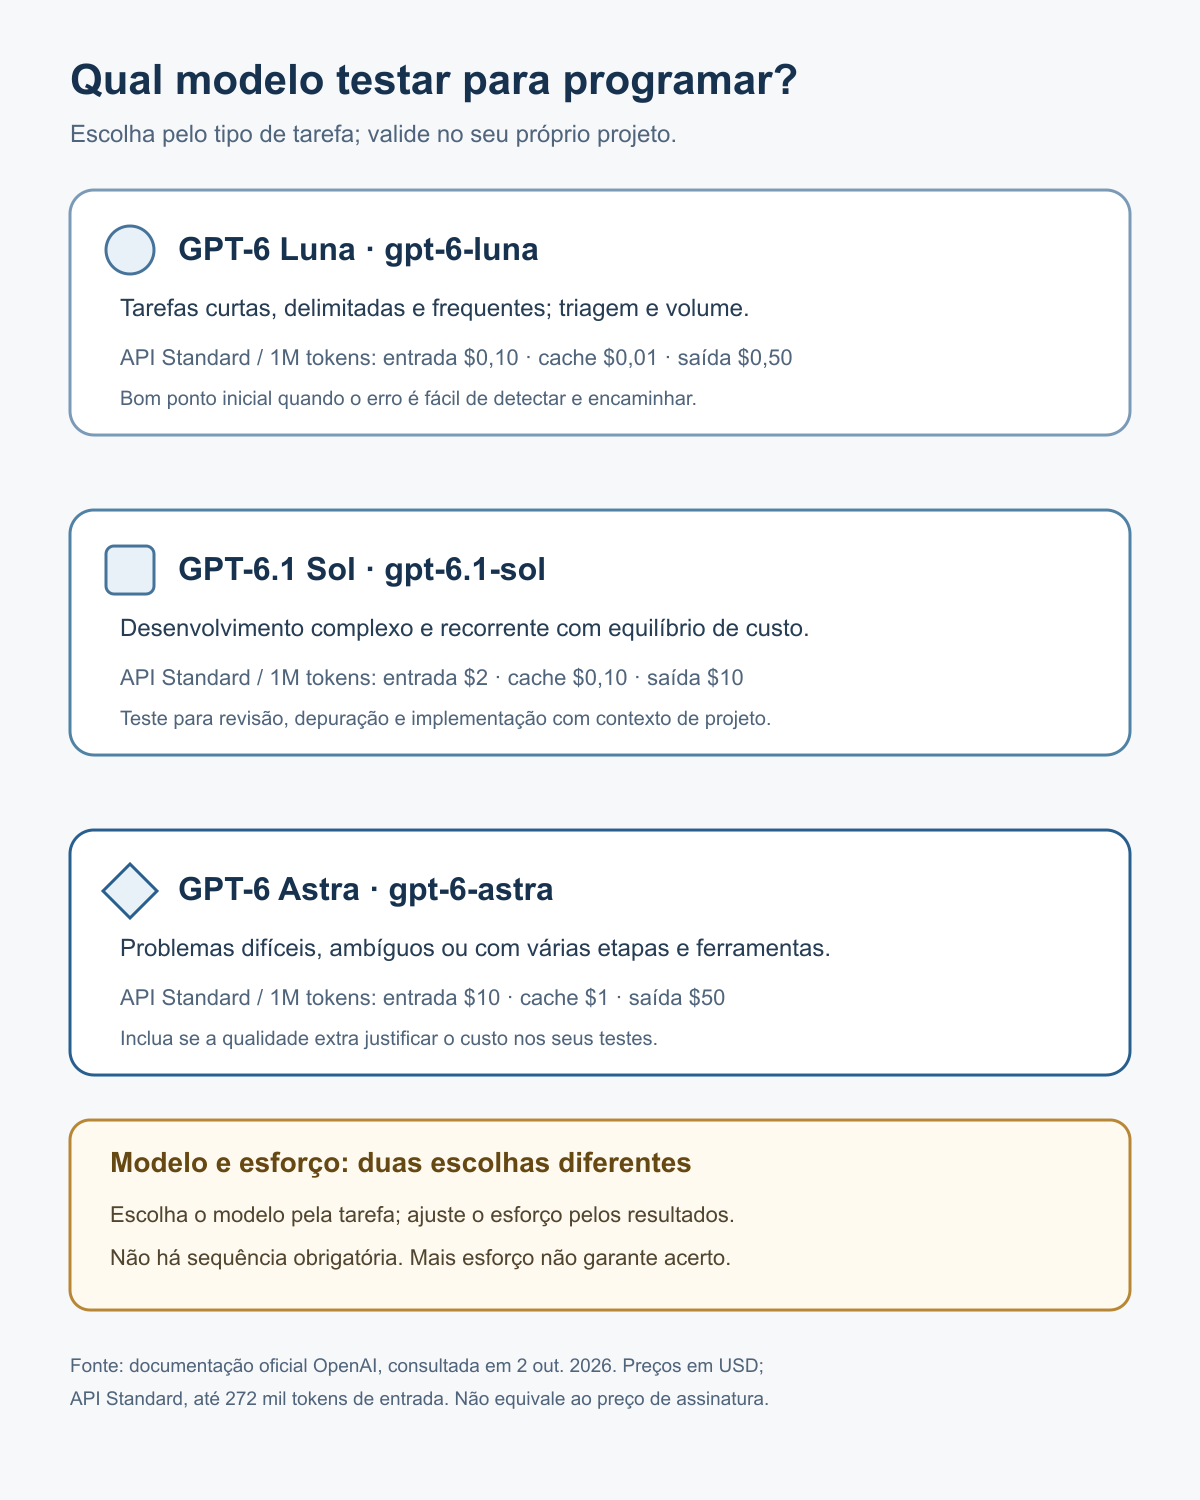
Orientação inicial, não classificação de desempenho. Fonte dos preços: documentação oficial da OpenAI, consultada em 2 out. 2026.
Um roteiro prático para escolher em um projeto
- Defina a tarefa. Separe geração de função, correção, revisão, migração, explicação e processamento em lote.
- Comece pelo modelo mais econômico que parece plausível. Para extração simples ou sumarização curta, experimente Luna. Para desenvolvimento complexo do dia a dia, compare Sol. Para mudanças ambíguas ou análise técnica de alto risco, inclua Astra no teste. Esse escalonamento é uma estratégia de avaliação, não uma garantia de qualidade.
- Prepare testes representativos. Use a mesma tarefa para comparar configurações. Remova segredos; confira se a alteração compila, passa nos testes, preserva regras e exige menos correções manuais. Registre resultados, não apenas impressões.
- Meça custo por resultado aprovado. Registre tokens, cache, chamadas, tempo, falhas e revisões humanas. Uma resposta rejeitada não equivale a uma alteração pronta para revisão.
- Mantenha limites de segurança. Execute testes em ambiente controlado, restrinja permissões de agentes, revise diffs e nunca exponha credenciais. Teste segurança somente em sistemas autorizados.
Um pedido mais útil para quem desenvolve em Delphi
O pedido ao modelo, chamado prompt, ganha clareza quando informa ambiente, problema, restrições e critérios de aprovação, como orienta a documentação de instruções para programação. Neste caso fictício, VCL é a biblioteca de interfaces Windows do Delphi e FireDAC é sua camada de acesso a dados. Use o exemplo com o trecho real e logs sem segredos; ele é uma especificação ilustrativa, sem teste executado:
Ambiente: Delphi 12, aplicação VCL, FireDAC e PostgreSQL.
Problema: a rotina grava um pedido e seus itens. Quando um item falha,
há relatos de pedidos sem todos os itens. Analise o código e os logs
fornecidos junto deste pedido antes de concluir a causa.

Objetivo: preservar a atomicidade: ou tudo é gravado, ou nada é gravado.
Restrições: não alterar o esquema do banco, regras de negócio nem
assinaturas públicas. Não adicionar dependências sem justificar.

Separe hipóteses de evidências, indique o menor ajuste necessário e
explique seu impacto. Se faltarem informações decisivas, pergunte.
Proponha testes para sucesso, falha em um item e reversão da transação.
Informe quais testes foram executados e quais são apenas sugestões.
Eu começaria esse diagnóstico com Sol e esforço médio. Se envolver operações simultâneas disputando recursos — concorrência — ou vários módulos, compararia alto e, conforme os resultados, Astra. O critério é verificar a atomicidade com testes, incluindo a reversão da transação em caso de falha, chamada rollback.
Quando a resposta falhar
Envie o erro exato de compilação ou do teste, o resultado esperado e o trecho relevante. Reduza a alteração e complete o contexto antes de elevar o esforço. Se a resposta usar uma função inexistente, peça a referência compatível com sua versão. Se os erros persistirem com informações suficientes, compare outro nível ou modelo na mesma tarefa. Evite repetir indefinidamente o mesmo pedido: registre as tentativas e o custo até obter uma mudança aprovada.
Quanto custa uma chamada e quanto custa concluir a tarefa?
Considere uma chamada com 100 mil tokens de entrada e 20 mil de saída faturada, sem cache. Esses 20 mil incluem texto visível e raciocínio interno. Pelas tarifas padrão, custaria US$ 2,00 em Astra, US$ 0,40 em Sol e US$ 0,02 em Luna. É uma conta hipotética, não uma tarefa típica nem uma medição de desempenho.
Uma resposta curta pode custar mais do que o texto sugere. Na Responses API, interface usada para solicitar respostas aos modelos, usage.output_tokens informa o total de saída e output_tokens_details.reasoning_tokens detalha sua parcela interna; somá-la novamente duplicaria a contagem (documentação de raciocínio). Um agente pode fazer várias chamadas e usar ferramentas: meça o custo até a alteração ser aprovada, não apenas o de uma resposta.
Acima de 272 mil tokens de entrada, as tarifas de entrada/cache dobram e as de saída passam a 1,5 vez, segundo a tabela oficial. Processamento em lote e outros modos têm condições próprias. A tabela inicial não cobre todas as modalidades; confirme também eventuais tarifas de gravação de cache, isto é, armazenamento do contexto para reutilização.
Modelos com desligamento programado
“Descontinuado” não significa que a API já rejeite a chamada: o encerramento foi anunciado. GPT-5.3-Codex foi descontinuado em 1º de outubro de 2026 e será removido em 1º de abril de 2027. Isso se refere ao modelo, não ao encerramento do produto Codex (aviso oficial).
A tabela seleciona identificadores pertinentes à programação, não todos os desligamentos. Um snapshot é uma versão específica, normalmente identificada por data; um alias é um nome que pode apontar para uma versão administrada pelo fornecedor. Confira o identificador exato utilizado pela integração.
| Modelo ou identificador | Desligamento anunciado | Substituição recomendada |
|---|---|---|
gpt-4.1-nano | 23 out. 2026 | gpt-5.6-luna |
gpt-5-2025-08-07 | 11 dez. 2026 | gpt-5.6-sol |
gpt-5-mini-2025-08-07 | 11 dez. 2026 | gpt-5.6-terra |
gpt-5-nano-2025-08-07 | 11 dez. 2026 | gpt-5.6-luna |
gpt-5.3-codex | 1 abr. 2027 | gpt-6-sol |
gpt-5.1 | 1 abr. 2027 | gpt-6-sol |
gpt-5.4-nano | 1 abr. 2027 | gpt-6-luna |
Deslize a tabela para os lados para ver todas as colunas.
As substituições são as registradas nos avisos oficiais, não uma classificação dos modelos atuais. GPT-6 Sol é anterior ao GPT-6.1 Sol, conforme sua página de modelo. A presença dele e da família GPT-5.6 na tabela preserva a orientação dos avisos; adotar outro modelo exige avaliação própria. Faça inventário, teste os substitutos e migre antes dos prazos. Confira novamente esta fotografia de 2 out. 2026 antes de alterar sistemas.
Limitações e cuidados ao comparar
Os preços consultados são da API, não de assinaturas, e não incluem câmbio, tributos ou ferramentas. Confirme as condições vigentes antes de orçar. O catálogo muda, e este guia não pretende enumerar todas as opções especializadas ou multimodais.
Não existe vencedor universal: o desempenho depende da linguagem, repositório, testes, instruções e ferramentas. Métricas do fornecedor ajudam a criar hipóteses, não substituem avaliação própria. Em regras fiscais, segurança e integridade de dados, mantenha revisão proporcional ao risco, mesmo quando o trecho alterado for pequeno.
Conclusão
Para escolher no cotidiano, teste Luna em tarefas delimitadas, Sol em desenvolvimento complexo recorrente e Astra quando a dificuldade justificar. Ajuste o esforço separadamente, comparando resultados antes de assumir o custo de níveis superiores. Um modelo mais caro ou mais tempo de raciocínio não dispensam contexto, testes e revisão.
A melhor configuração é a que entrega uma alteração confiável com custo e prazo aceitáveis no seu projeto. Meça o trabalho completo, incluindo tentativas e correções, e planeje a migração das integrações com desligamento anunciado. Assim, a escolha deixa de seguir apenas nomes e passa a refletir evidências do desenvolvimento real.
Se a comparação já ajudou a escolher um ponto de partida, o próximo desafio é organizar contexto, ferramentas e critérios de qualidade ao redor do modelo. Esse é o percurso de IA Além da Conversa. Consulte o sumário e a degustação gratuita na página do livro para avaliar esse aprofundamento antes de escolher sua edição.
Referências
OPENAI. Changelog. OpenAI API, set. 2026. Disponível em: https://developers.openai.com/api/docs/changelog. Acesso em: 2 out. 2026.
OPENAI. Code generation. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/guides/code-generation. Acesso em: 2 out. 2026.
OPENAI. Deprecations. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/deprecations. Acesso em: 2 out. 2026.
OPENAI. GPT-5.3-Codex model. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/models/gpt-5.3-codex. Acesso em: 2 out. 2026.
OPENAI. GPT-6 Sol model. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/models/gpt-6-sol. Acesso em: 2 out. 2026.
OPENAI. Models. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/models. Acesso em: 2 out. 2026.
OPENAI. Pricing. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/pricing. Acesso em: 2 out. 2026.
OPENAI. Prompt engineering. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/guides/prompt-engineering. Acesso em: 2 out. 2026.
OPENAI. Reasoning models. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/guides/reasoning. Acesso em: 2 out. 2026.
OPENAI. Using GPT-6. OpenAI API, [s. d.]. Disponível em: https://developers.openai.com/api/docs/guides/latest-model. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. SDD em Delphi. 1. ed. 2026. Disponível em: https://livros.regys.com.br/sdd-em-delphi. Acesso em: 3 out. 2026.
0 comentário(s)