

Um pedido chega por e-mail, acompanhado de um PDF. Na tela, quantidade, preço e total parecem claros. A próxima ideia é pedir à inteligência artificial que leia o arquivo e preencha o sistema. Antes de escolher o modelo, porém, existe uma pergunta mais básica: de que maneira essas informações estão armazenadas e qual evidência permitirá conferir o preenchimento?
O mesmo conteúdo pode estar em texto recuperável, numa fotografia da página ou em campos identificados de um arquivo estruturado. Essas representações exigem caminhos diferentes. Além disso, reconhecer um número não demonstra que ele pertence ao campo certo, corresponde à versão vigente ou autoriza uma ação. Para desenvolvimento e contabilidade, essa separação é mais importante que a aparência convincente da resposta.
Este artigo explica os conceitos necessários, apresenta um ensaio executado com arquivos fictícios e propõe critérios para usar extração, reconhecimento de caracteres e interpretação visual. O objetivo não é automatizar qualquer documento, mas organizar um processo em que informação, origem e conferência permaneçam juntas.
Se sua dificuldade é transformar uma resposta da IA em um processo verificável, conheça a página de IA além da conversa. Essa é a conexão central com o tema: o modelo participa da leitura, mas a arquitetura precisa definir como o resultado será utilizado e conferido.
A aparência da página não revela sua estrutura
Extração textual significa recuperar caracteres que já estão representados como texto no arquivo. Não é necessário reconhecer visualmente cada letra quando essa informação está disponível. Ainda assim, uma sequência extraída não deve ser confundida automaticamente com a ordem de leitura ou com a organização dos campos que a pessoa percebe na página.
Reconhecimento óptico de caracteres, conhecido pela sigla OCR, procura transformar imagens de letras e números em texto. Ele entra em cena quando a informação está nos pixels, os pequenos pontos que compõem a imagem. Um documento digitalizado pode receber posteriormente uma camada de texto produzida por OCR, sem que isso transforme o reconhecimento anterior em uma transcrição infalível.
A documentação do pypdf sobre extração diferencia PDFs produzidos digitalmente, digitalizados e submetidos a OCR. A biblioteca não faz reconhecimento de caracteres em imagens. A documentação também explica dificuldades de organização do texto, inclusive quando tabelas são representadas por caracteres posicionados na página. Portanto, a extensão PDF, sozinha, não define a técnica de leitura adequada.
Para o leitor, selecionar uma frase no visualizador pode servir como pista inicial. Para a aplicação, o diagnóstico deve ser feito com o extrator que será realmente utilizado e com documentos representativos. A pista visual não substitui um teste: um arquivo pode combinar páginas ou regiões com naturezas diferentes, e a utilidade do resultado depende dos campos necessários à tarefa.
Multimodalidade acrescenta interpretação visual
Um modelo multimodal trabalha com mais de uma modalidade de informação, como texto e imagem. No nosso caso, interessa a possibilidade de interpretar uma página considerando também sua apresentação visual. Isso é diferente de simplesmente enviar ao modelo uma lista de caracteres obtida por um extrator.
A documentação de processamento de documentos do Gemini, consultada em 3 de outubro de 2026, descreve interpretação de texto, imagens, diagramas, gráficos e tabelas em PDFs. Ela distingue esse tratamento do envio de outros tipos de documento como texto. A capacidade documentada é do produto descrito: não permite presumir que qualquer ferramenta que aceite anexos interprete a página da mesma maneira.
Como critério de projeto, eu usaria a interpretação visual quando a posição e a relação entre elementos fossem necessárias para responder. Uma observação associada a determinado item, por exemplo, exige mais que localizar palavras. Já para recuperar um campo disponível numa estrutura conhecida, começar por interpretação visual pode acrescentar uma etapa que o problema não exige.
Essa escolha não é uma escada obrigatória de sofisticação. Extração, OCR e modelo multimodal são caminhos a avaliar conforme a representação e a tarefa. Não executei uma comparação de qualidade entre modelos neste artigo. O ensaio seguinte testa uma distinção anterior: o que acontece quando a mesma página deixa de conter texto recuperável.
Um ensaio com o mesmo pedido em representações diferentes
Criei um pedido inteiramente fictício, identificado como DEMO-001 e sem valor fiscal. Ele contém quantidade 2, valor unitário 125,50, total 251,00 e a observação “nao efetuar pagamento”. A ausência de acentos nessa frase pertence ao arquivo de teste e não altera o ponto que precisamos preservar: a negação faz parte da informação.
O primeiro PDF foi gerado com texto. Depois, sua página foi renderizada como imagem e inserida em outro PDF. Os dois foram conferidos visualmente, mas somente o primeiro preservou a representação textual usada pelo extrator. Acrescentei um XML didático em memória com campos de quantidade, valor unitário e total. XML é uma linguagem de marcação que permite identificar elementos; esse exemplo não é um leiaute de documento fiscal.
O teste usou pypdf 6.10.0 e um analisador XML da biblioteca padrão do Python. A extração do PDF textual recuperou o total e a observação. No PDF composto somente da imagem, retornou texto vazio. A leitura do elemento total no XML encontrou 251.00. As verificações programadas passaram. O código e o registro do ensaio foram preservados na pesquisa deste artigo (Silveira, 2026).
O resultado não significa que o segundo arquivo seja ilegível para uma pessoa ou para outra tecnologia. Significa que aquele caminho de extração não encontrou texto. Também não prova que OCR ou um modelo visual recuperariam corretamente todos os campos, pois nenhum deles foi executado no ensaio. Essa delimitação impede transformar um teste de representação em uma promessa de precisão.
Estrutura ajuda a localizar mas não valida o conteúdo
O XML didático tornou explícito qual elemento se chamava total. Essa vantagem de localização não demonstra que o valor esteja correto. Como recomendação de engenharia, a aplicação deve comparar os campos com o contrato esperado e verificar regras independentes da técnica que os recuperou.
No pedido fictício, podemos conferir que duas unidades de 125,50 correspondem a 251,00. Essa conta só é suficiente porque o exemplo declara um escopo simples. Em documentos reais, descontos, adicionais, arredondamentos e regras do negócio precisam ser definidos antes de aplicar uma igualdade semelhante. Não se deve inventar uma regra universal a partir de uma demonstração pequena.
Também precisamos distinguir ausência de zero. Se um total não foi encontrado, preencher zero elimina justamente a informação de que houve uma falha de leitura. Eu registraria o campo como ausente, manteria a origem e encaminharia a exceção à revisão. Uma proposta incompleta pode ser útil; uma proposta que esconde a própria incompletude é mais difícil de conferir.
Esse raciocínio complementa o artigo sobre RAG com documentos da empresa. RAG é a recuperação de informações para apoiar uma resposta. Antes de buscar bons trechos, precisamos evitar que a leitura inicial descarte observações, associe valores incorretamente ou perca a identificação do documento.
Qualidade da entrada precisa de critérios
A documentação do Tesseract sobre qualidade discute inclinação da página, ruído, contraste, segmentação e dificuldades de reconhecimento em tabelas. São condições para investigação, não garantias de resultado. A documentação do Gemini também recomenda páginas na orientação correta e sem desfoque.
Minha proposta prática é separar problemas de entrada de problemas de interpretação. Se uma fotografia corta a última linha, pedir uma resposta mais detalhada não recupera a região ausente. Se uma coluna ficou ambígua, o processo precisa admitir a dúvida. Melhorar a entrada pode significar solicitar outro arquivo, conservar a versão original e comparar o resultado, em vez de insistir numa resposta aparentemente completa.
Defina critérios por campo e consequência. Num exercício de resumo, uma descrição aproximada pode permitir revisão editorial. Num preenchimento de pedido, quantidade e preço exigem conferência explícita. Uma identificação que liga o documento a um cadastro merece atenção própria, pois uma leitura correta associada à empresa errada continua sendo um resultado inadequado.
Não apresento uma taxa geral de acerto porque ela não foi medida. O caminho recomendável é montar um conjunto de documentos autorizado e representativo, registrar a resposta esperada e comparar os erros. Inclua arquivos problemáticos e campos ausentes, não apenas exemplos limpos. A avaliação deve mostrar também quando o sistema precisa recusar o preenchimento automático.
Um fluxo aplicável ao sistema e ao trabalho diário
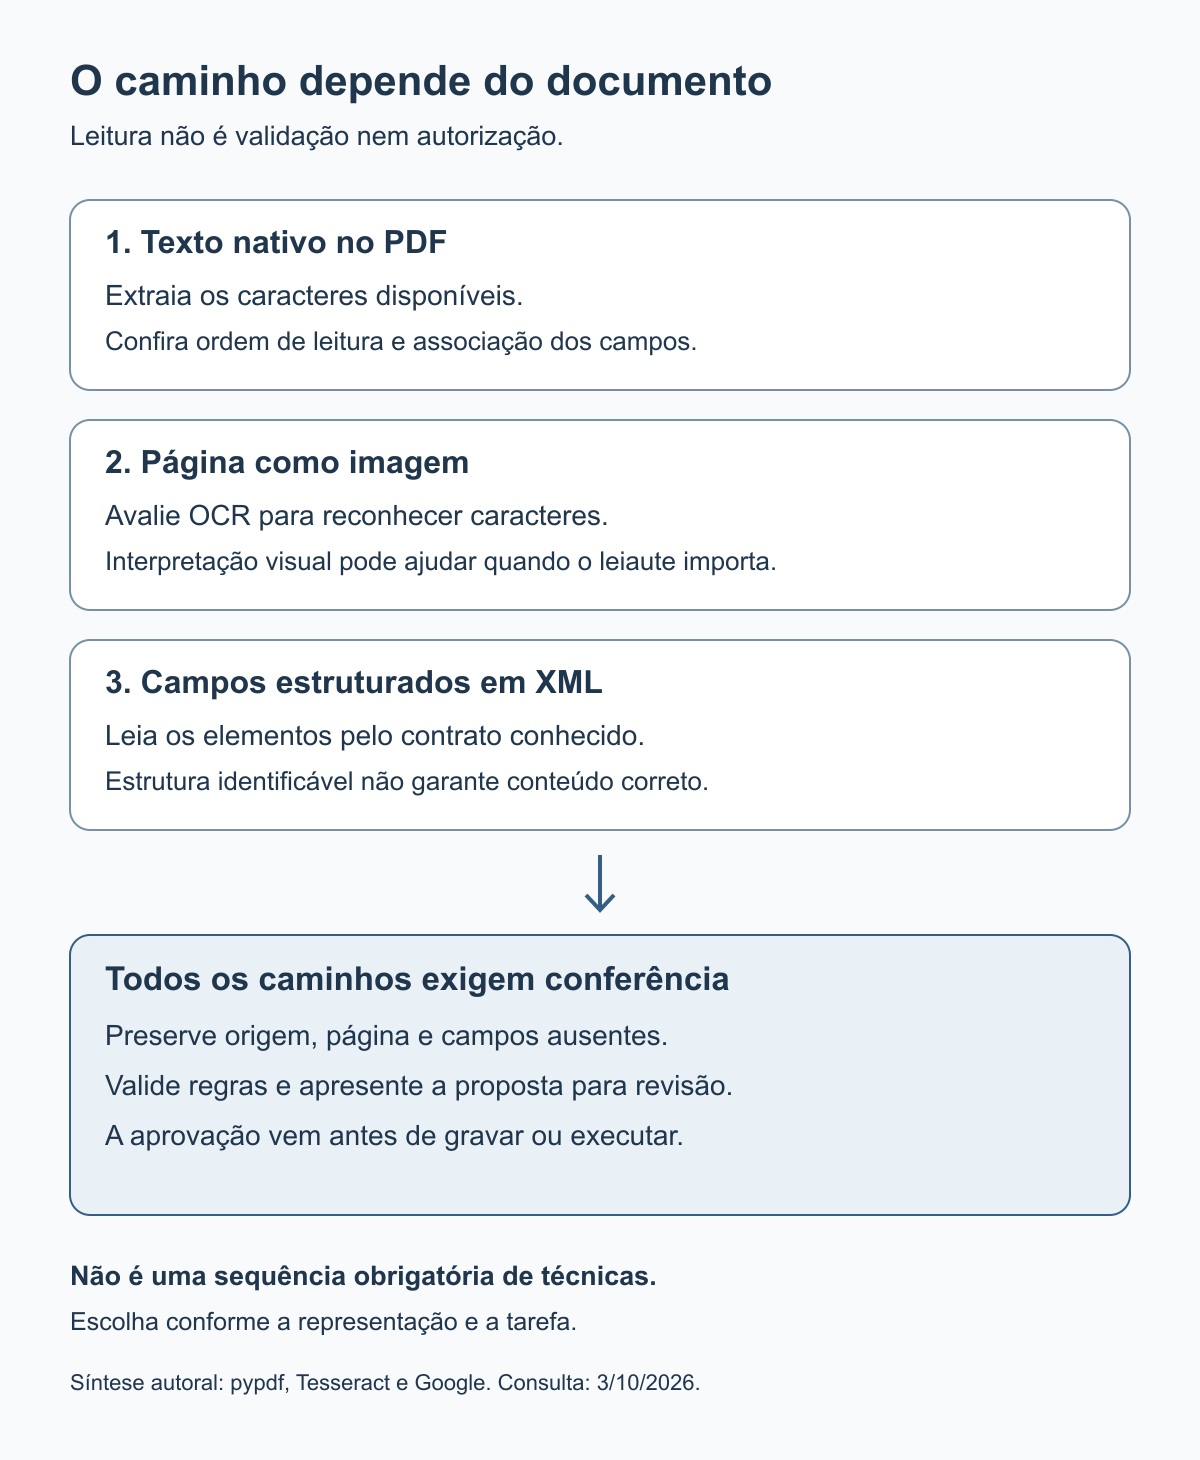
Síntese autoral das documentações de pypdf, Tesseract e Google consultadas em 3 de outubro de 2026. Os caminhos são alternativas conforme a tarefa, não uma sequência obrigatória.
Como arquitetura proposta, eu separaria recebimento, leitura, interpretação, validação e aprovação. No recebimento, registre de onde veio o arquivo e qual tarefa foi solicitada. Na leitura, escolha a técnica e preserve seu resultado. Na interpretação, associe informações aos campos necessários, sem autorizar a execução de operações.
Na validação, compare tipos, campos obrigatórios e regras do negócio. Na aprovação, mostre o documento e a proposta lado a lado, permitindo identificar a origem dos valores. Só depois dessa decisão a aplicação deve efetivar uma mudança. Essa separação ajuda a testar partes do processo sem depender de uma resposta textual como autorização.
Para uma aplicação Delphi, o leitor do documento pode ser um componente ou serviço, mas o contrato de saída deve pertencer ao sistema. A interface de revisão precisa distinguir campo confirmado, ausente e divergente. Não basta exibir um botão de aprovação: a pessoa deve conseguir compreender o que será gravado e qual evidência foi usada.
É nessa passagem de capacidade para operação que IA além da conversa se conecta ao artigo. O documento não é apenas um anexo entregue ao modelo; ele participa de um fluxo com critérios, responsabilidades e limites. O ganho esperado deve vir da redução do trabalho de conferência, não da retirada da conferência sem evidência.
Limitações e cuidados
Um documento recebido deve permanecer fonte de informação, não fonte de autorização para a ferramenta. A discussão de prompt injection em documentos explica por que instruções encontradas no conteúdo precisam ser separadas das regras legítimas da tarefa. Interpretar uma página não dá a ela autoridade para mandar no processo.
Antes de enviar arquivos a um serviço externo, confira se esse uso é permitido pela organização e pelas condições contratadas. Não use documentos de clientes num piloto por conveniência. Dados fictícios permitem testar parte do fluxo; avaliações com dados reais exigem tratamento e autorização adequados ao contexto. Este artigo não substitui uma análise jurídica de proteção de dados.
Por fim, o ensaio não valida autenticidade, assinatura, autorização fiscal ou conformidade tributária. Tampouco mede segurança ao abrir arquivos hostis ou desempenho com grande volume. Cada uma dessas propriedades exige uma verificação própria. A leitura é uma etapa do sistema, e não um certificado abrangente sobre o documento.
Conclusão
Usar IA para ler documentos começa por escolher uma representação e uma tarefa, não por presumir que todo anexo se comporta da mesma forma. O ensaio mostrou que dois PDFs visualmente equivalentes podem produzir resultados diferentes no mesmo extrator. Também mostrou por que campos identificados facilitam a localização sem dispensar regras de conferência.
A decisão prática é preservar documento, origem, campos ausentes e evidências até a aprovação. Se o sistema não consegue demonstrar de onde veio um valor ou quando deve pedir ajuda, o próximo passo é melhorar o processo antes de ampliar a autonomia. Para aprofundar essa arquitetura, conheça a amostra gratuita de IA além da conversa e avalie se o livro atende à sua próxima necessidade de implementação.
Referências
GOOGLE. Document understanding. Google AI for Developers, 23 set. 2026. Disponível em: https://ai.google.dev/gemini-api/docs/document-processing. Acesso em: 3 out. 2026.
PYPDF. Extract Text from a PDF. pypdf documentation, [s. d.]. Disponível em: https://pypdf.readthedocs.io/en/stable/user/extract-text.html. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. Ensaio de extração de pedido fictício. Código Python e registro de execução local, 3 out. 2026. Material de pesquisa deste artigo.
SILVEIRA, Régys Borges da. IA além da conversa. Página oficial do livro, [s. d.]. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
TESSERACT OCR. Improving the quality of the output. tessdoc, [s. d.]. Disponível em: https://tesseract-ocr.github.io/tessdoc/ImproveQuality.html. Acesso em: 3 out. 2026.
0 comentário(s)