

Durante os últimos anos, inteligência artificial aplicada a software tornou-se quase sinônimo de grandes modelos de linguagem, os LLMs. Quando um sistema precisa classificar uma solicitação, escolher uma ferramenta ou avaliar um texto, tornou-se comum enviar um prompt a um modelo generativo e pedir uma resposta em JSON. Essa solução funciona, mas levanta uma pergunta importante: se o programa precisa somente de uma decisão, por que utilizar um mecanismo projetado principalmente para gerar linguagem?
O Jev, apresentado pela TypeSafe AI em setembro de 2026, parte dessa pergunta. Em vez de escrever uma explicação, ele recebe informações sobre um caso e responde a perguntas delimitadas com valores tipados e probabilidades. A proposta chama atenção pelo custo e pela velocidade divulgados, mas o aspecto mais interessante é arquitetural: o modelo não recebe autoridade sobre o fluxo; ele fornece julgamentos que o código pode combinar, limitar e encaminhar para revisão.
Neste artigo, explicarei o paradigma que sustenta o Jev, suas três primitivas, uma integração prática e os critérios para escolher entre Jev, LLM, regras determinísticas e classificadores tradicionais. Também examinarei limitações e pesquisas iniciais, porque saída estruturada, confiança e baixo custo não tornam uma decisão automaticamente correta.
A escolha entre uma decisão tipada e uma resposta gerada só faz sentido dentro do processo que utilizará o resultado. IA Além da Conversa aprofunda a arquitetura ao redor dos modelos: contexto, ferramentas, permissões, avaliação e operação. Conheça a proposta e leia a degustação gratuita para avaliar como definir essas fronteiras no seu projeto. Para registrar comportamentos esperados, exceções e critérios de aceite em uma implementação Delphi, SDD em Delphi oferece um percurso complementar. São conexões de método, não uma afirmação de que os livros ensinam especificamente o Jev.
Nem toda chamada de IA precisa gerar texto
Um LLM é um modelo generativo: recebe um contexto e produz uma sequência de tokens. Essa flexibilidade permite conversar, resumir, programar, planejar e criar conteúdo. Mesmo quando recebe um esquema JSON, sua operação continua sendo gerar uma sequência que satisfaça o contrato solicitado. Em tarefas abertas, essa é justamente a vantagem. Para uma visão mais ampla sobre o que existe além do modelo isolado, veja também IA além da conversa: o que existe entre o modelo e uma solução confiável.
Muitas rotinas empresariais, porém, não possuem uma resposta aberta. Um chamado precisa ser encaminhado para faturamento, suporte técnico ou vendas. Uma mensagem pode conter ou não dados pessoais. Um documento deve receber uma categoria dentre as cadastradas. Nesses casos, o espaço de respostas já é conhecido e o resultado será consumido por código, não por uma pessoa interessada em ler uma boa explicação.
Esse é o domínio dos modelos de decisão. Em vez de perguntar “o que você faria?”, a aplicação apresenta as opções permitidas e solicita um julgamento específico. O modelo não inventa uma quarta área, não redige uma justificativa e não executa a ação. A inteligência interpreta o caso; o programa mantém o controle operacional.
O paradigma: da geração de linguagem à decisão tipada
A TypeSafe chama o Jev de seu primeiro modelo “System One”. O nome vem da distinção popularizada por Daniel Kahneman entre um Sistema 1 rápido e intuitivo e um Sistema 2 lento e deliberado. No contexto do produto, a metáfora descreve julgamentos rápidos e focados, não uma equivalência demonstrada entre o modelo e a cognição humana.
O paradigma pode ser resumido por um contrato: a aplicação fornece um estado, define perguntas atômicas e recebe respostas tipadas acompanhadas de probabilidades. O estado pode ser um texto ou uma estrutura JSON com dados do chamado, do cliente e da política aplicável. Cada pergunta deve representar um julgamento estreito que alguém bem informado conseguiria fazer rapidamente. Se a pergunta exige decompor fatores, pesquisar, calcular ou planejar várias etapas, ela provavelmente está fora desse paradigma.
A documentação atribui o treinamento a uma abordagem denominada Reinforcement Learning for Calibrated Decisions (RLCD), ou aprendizado por reforço para decisões calibradas. A intenção declarada é que probabilidades maiores correspondam, em conjuntos de previsões, a frequências maiores de acerto. Essa calibração é coletiva: uma resposta com 90% não traz garantia individual de correção. Ela oferece um sinal que precisa ser validado no domínio real antes de orientar automações.
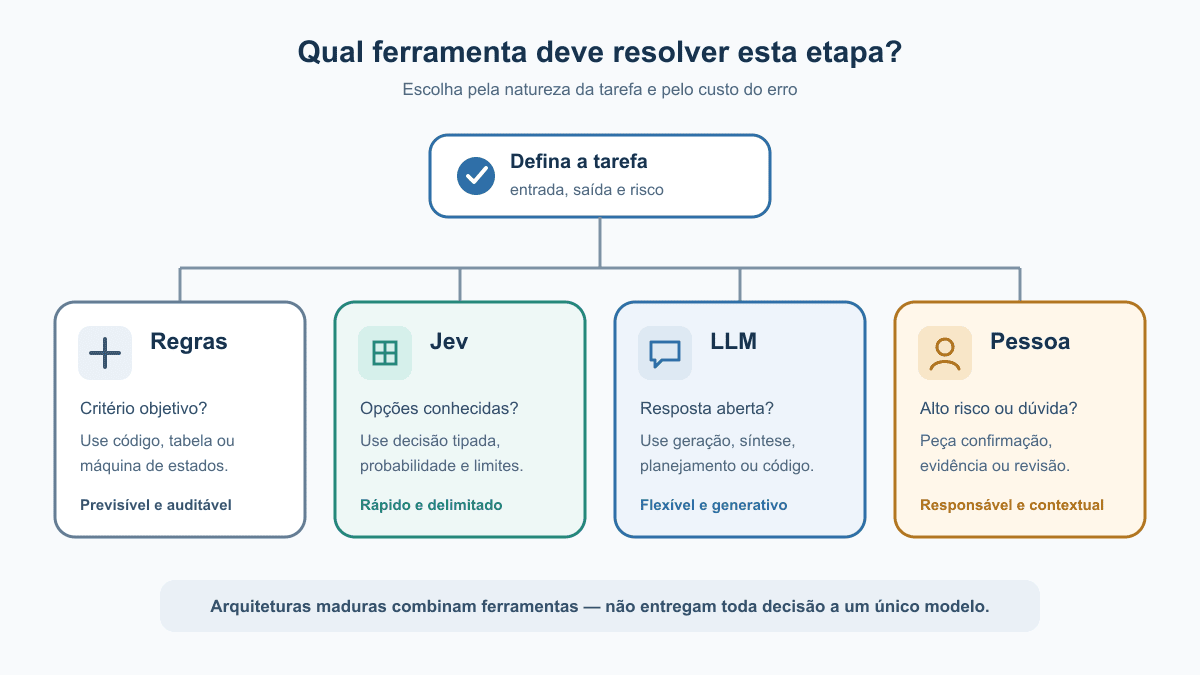
Uma arquitetura segura escolhe a ferramenta conforme a natureza e o risco da tarefa. O modelo propõe um julgamento; o código controla o efeito.
O que é o Jev e como ele transforma estado em decisão
O Jev não é um chatbot e não produz texto livre. Para entender como ele funciona, primeiro é necessário conhecer dois conceitos usados na integração. API é a interface pela qual um programa conversa com outro serviço. JSON é um formato textual organizado em nomes e valores, utilizado para transportar as informações dessa conversa. A aplicação envia uma requisição em JSON e recebe uma resposta no mesmo formato.
Dentro dessa requisição aparecem alguns campos com nomes em inglês. Eles não são comandos misteriosos, mas partes do contrato definido pela API:
statesignifica estado: é o conjunto de informações que descreve o caso a ser avaliado. Pode ser uma mensagem simples ou um objeto com chamado, cliente, transações e política aplicável. O Jev não consulta automaticamente o banco de dados da empresa; a aplicação decide quais dados entram nesse estado.modelidentifica qual versão do modelo processará a requisição. O valorjev-latestaponta para a versão corrente indicada pela TypeSafe, enquanto uma versão fixa ajuda a evitar mudanças inesperadas de comportamento em produção.questionsreúne as perguntas que serão feitas sobre o mesmo estado. Cada pergunta recebe um nome escolhido pelo desenvolvedor, comoareaouurgente. Esse nome funciona como identificador para localizar a resposta correspondente.typeinforma qual formato de resposta a pergunta deve produzir. É nesse campo que a aplicação escolhe entrechoice,scoreenoul.instructionsdescreve o julgamento solicitado. Deve ser uma pergunta clara e específica, como “qual área deve tratar esta mensagem?”, e não uma ordem ampla como “analise tudo e decida o que fazer”.criteriadefine as alternativas ou os níveis permitidos. Em uma classificação de chamados, por exemplo, pode descrever o que significa financeiro, suporte, comercial e revisão.
Há três formatos de pergunta. Choice, ou escolha, seleciona uma alternativa em um conjunto sem ordem, como o departamento responsável. Score, ou pontuação, posiciona o caso em uma escala descrita, como níveis de frustração. Noul avalia uma afirmação binária e devolve a probabilidade de “sim”. O nome incomum de Noul não muda sua finalidade prática: alimentar uma condição do programa com um valor entre zero e um.
Para Choice e Score, a resposta inclui probabilities, isto é, a distribuição de probabilidade entre todas as alternativas, e confidence, um resumo numérico de quanto uma opção se destacou. Distribuições concentradas indicam uma escolha mais definida; distribuições achatadas sugerem ambiguidade. Noul não possui confiança separada, pois o próprio valor retornado já representa a probabilidade positiva.
Com esses conceitos apresentados, o contrato completo fica mais simples: a API recebe um state, a identificação do model e um conjunto de questions. Cada resposta volta associada ao mesmo identificador usado pela aplicação. O programa consegue, assim, localizar os resultados sem extrair uma decisão de um texto livre, registrá-los para auditoria e combiná-los com regras convencionais.
O ponto essencial é que “tipado” significa válido para processamento, não verdadeiro. Um objeto pode chegar perfeitamente formado, selecionar uma categoria existente e ainda assim escolher a categoria errada.
Jev na prática: triagem de chamados sem entregar o fluxo ao modelo
Considere um ERP que recebe a mensagem: “Fui cobrado duas vezes no pedido A-104 e preciso do estorno hoje”. A aplicação quer descobrir a área responsável, a urgência e o grau de frustração. Uma única requisição pode formular três perguntas independentes:
{
  "state": {
    "mensagem": "Fui cobrado duas vezes no pedido A-104 e preciso do estorno hoje",
    "cliente": { "plano": "empresarial" }
  },
  "model": "jev-latest",
  "questions": {
    "area": {
      "type": "choice",
      "instructions": "Qual área deve tratar a mensagem?",
      "criteria": {
        "financeiro": "Cobranças, pagamentos, faturas e estornos",
        "suporte": "Erros, indisponibilidade e integrações",
        "comercial": "Preços, planos e novas contratações",
        "revisao": "Nenhuma categoria descreve o caso com clareza"
      }
    },
    "urgente": {
      "type": "noul",
      "instructions": "A mensagem expressa necessidade explícita de atendimento urgente?"
    },
    "frustracao": {
      "type": "score",
      "instructions": "Qual é o grau de frustração expresso na mensagem?",
      "criteria": ["Neutro", "Preocupado, mas cordial", "Muito irritado"]
    }
  }
}
O envio é feito por POST para https://api.typesafe.ai/v1/systemone, com a chave no cabeçalho Authorization. O corpo segue a referência oficial da API, consultada em 1º de outubro de 2026. O exemplo não foi executado contra o serviço por não haver credencial do fornecedor no ambiente de produção editorial; sua sintaxe JSON foi validada localmente.
Em Delphi, a chamada pode ser feita com THTTPClient ou outro cliente HTTP. O detalhe mais importante não é a biblioteca, mas o que acontece depois da resposta. O código deve aplicar uma política explícita:
if AreaConfidence < 0.70 then
  EncaminharParaRevisao
else if Area = 'financeiro' then
  CriarTarefaFinanceira;

if ProbabilidadeUrgente >= 0.85 then
  MarcarComoPrioridade;
Os valores 0.70 e 0.85 são exemplos didáticos, não recomendações universais. Uma empresa deve defini-los com chamados previamente classificados, observar falsos positivos e falsos negativos e usar limites mais conservadores para ações irreversíveis. Exibir a tela errada é recuperável; autorizar um pagamento não é.
Onde o Jev faz sentido no dia a dia
O Jev se ajusta melhor a decisões frequentes, estreitas e semanticamente ambíguas. Exemplos incluem rotear chamados, classificar documentos, pontuar risco, selecionar uma ferramenta de agente, avaliar se uma passagem sustenta uma resposta de RAG e verificar uma saída de LLM contra critérios conhecidos. Também pode atuar antes de um LLM, escolhendo qual modelo ou prompt especializado receberá a solicitação.
Ele não é indicado para redigir uma resposta ao cliente, resumir um contrato, explicar um erro, produzir código ou criar um plano. Também não deve substituir cálculos, validações cadastrais ou regras fiscais objetivas. Se uma condição pode ser expressa com segurança por if, tabela ou máquina de estados, introduzir um modelo probabilístico apenas torna o comportamento mais difícil de provar.
Jev, LLM, regras e classificadores são ferramentas diferentes
Regras determinísticas são a primeira escolha quando os critérios são objetivos, estáveis e completos. Elas são baratas, explicáveis e reproduzíveis, mas se tornam frágeis quando precisam interpretar linguagem variada.
Classificadores tradicionais fazem sentido quando há muitos exemplos rotulados, categorias relativamente estáveis e equipe capaz de treinar e operar o modelo. Podem oferecer execução local, controle de dados e custo marginal baixo, embora exijam preparação e manutenção do conjunto de treinamento.
O Jev ocupa a faixa em que faltam dados ou tempo para treinar um classificador, mas o espaço de decisões já está definido. Ele oferece interpretação semântica com saídas restritas. Já o LLM é apropriado quando a tarefa exige produzir linguagem, sintetizar informações, trabalhar com instruções abertas, usar ferramentas ou desenvolver raciocínio mais longo.
Essa comparação mostra por que “Jev versus LLM” é uma formulação incompleta. Em um sistema bem desenhado, eles podem colaborar: regras resolvem os casos objetivos; Jev realiza julgamentos delimitados; um LLM cuida da geração ou investigação; e uma pessoa recebe casos incertos ou de alto impacto.
Vantagens que precisam ser medidas, não presumidas
A ausência de geração token a token tende a favorecer latência e custo. Em uma avaliação recente com 37 conjuntos de dados, Deußer, Sparrenberg e Sifa executaram 346.009 solicitações por menos de dez dólares e observaram resultados competitivos em várias tarefas de classificação. O próprio estudo, contudo, encontrou degradação em idiomas com menos recursos, rótulos muito próximos, dados ruidosos e avaliações por rubrica. Em um teste jurídico separado, Zhang et al. encontraram o menor custo e tempo mediano para o Jev, enquanto modelos hospedados alcançaram maior acurácia básica.
Esses trabalhos são preprints recentes e não encerram a comparação. Seus números descrevem versões, conjuntos e protocolos específicos. A decisão de produção deve usar dados representativos da própria aplicação e medir pelo menos acurácia por classe, custo, latência, estabilidade e impacto dos erros. Para classes desbalanceadas, uma taxa média pode esconder falhas justamente nos casos raros e importantes.
Limitações, riscos e cuidados de produção
O primeiro risco é fornecer alternativas incompletas. Se Choice receber somente financeiro, suporte e comercial, um pedido jurídico será forçado para uma opção inadequada. Categorias como revisao ou nenhuma_das_anteriores criam uma rota de escape, mas também precisam ser testadas.
O segundo é confundir confiança com correção. Um modelo pode estar seguro e errado; além disso, mudanças de versão podem alterar distribuições e quebrar limites calibrados anteriormente. Em produção, convém fixar a versão, registrar estado, perguntas, respostas e modelo utilizado, e repetir a avaliação antes de atualizar.
O estado também é entrada não confiável. Uma mensagem pode conter instruções destinadas a influenciar o julgamento. Saídas tipadas limitam o formato, mas não eliminam manipulação semântica, vieses ou vazamento de dados. Informações pessoais, fiscais e contratuais exigem análise de privacidade, retenção, localização do processamento e termos do fornecedor.
Por fim, o modelo não explica seu raciocínio. Isso reduz o risco de aceitar uma justificativa inventada como prova, porém dificulta auditorias que exijam motivação individual. Em processos regulados ou com efeito relevante sobre pessoas, uma probabilidade não substitui evidência, fundamento normativo nem revisão responsável.
Uma arquitetura híbrida costuma ser a resposta mais madura
Uma implementação segura começa definindo a decisão antes de escolher o modelo. Em seguida, separa fatos determinísticos de julgamentos semânticos, cria perguntas atômicas, adiciona uma saída de revisão e estabelece limites proporcionais ao risco. O próximo passo é montar um conjunto rotulado com situações comuns, exceções, ambiguidades e tentativas de manipulação.
Depois da avaliação, a automação pode adotar três faixas: agir nos casos de baixo risco e alta confiança, pedir confirmação ou informação adicional na faixa intermediária e interromper ou encaminhar quando houver incerteza. Métricas em produção devem mostrar não apenas quantos casos foram automatizados, mas quais erros ocorreram e quem foi afetado. Essa preocupação com processo, limites e verificação também aparece em IA na prática com Delphi, Lazarus e ACBr.
Conclusão
O Jev apresenta uma ideia útil: nem toda inteligência inserida em software precisa conversar, gerar texto ou controlar todo o processo. Quando a aplicação conhece as alternativas e precisa interpretar linguagem para escolher entre elas, uma decisão tipada pode oferecer um contrato mais simples e econômico que um LLM generativo.
Isso não transforma o Jev em substituto universal. Regras continuam superiores para condições objetivas; classificadores treinados podem ser melhores em domínios estáveis; LLMs permanecem adequados para geração e tarefas abertas; pessoas são indispensáveis diante de incerteza ou alto impacto. A escolha correta depende da forma da tarefa, da qualidade medida e do custo do erro.
A principal mudança de paradigma está em devolver ao código a responsabilidade pelo fluxo. O modelo julga uma parte pequena; a aplicação decide como combinar o resultado, quando agir e quando parar. É essa separação — mais do que qualquer promessa de velocidade — que torna o Jev relevante para arquiteturas de IA aplicadas ao dia a dia.
Se esse paradigma faz sentido para seu sistema, a próxima etapa é explicitar o que entra, quais decisões são permitidas e como conferir a saída. SDD em Delphi aprofunda contratos, critérios de aceite e rastreabilidade aplicáveis a esse desenho. A obra não é um manual de Jev: consulte o sumário e a degustação gratuita para avaliar a disciplina de engenharia que ela acrescenta ao uso da IA.
Referências
DEUSSER, Tobias; SPARRENBERG, Lorenz; SIFA, Rafet. Evaluating and Benchmarking the System One Model Jev. arXiv, 29 set. 2026. Disponível em: https://arxiv.org/abs/2609.37647. Acesso em: 1 out. 2026.
RAO, Delip; CALLISON-BURCH, Chris. JEV vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places. arXiv, 24 set. 2026. Disponível em: https://arxiv.org/abs/2609.29769. Acesso em: 1 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. SDD em Delphi. 1. ed. 2026. Disponível em: https://livros.regys.com.br/sdd-em-delphi. Acesso em: 3 out. 2026.
TYPESAFE AI. AI primer. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/introduction/machine-learning-primer. Acesso em: 1 out. 2026.
TYPESAFE AI. API reference. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/api. Acesso em: 1 out. 2026.
TYPESAFE AI. Confidence. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/confidence. Acesso em: 1 out. 2026.
TYPESAFE AI. Jev 1.13 jaggedness. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/model-jaggedness/jev-1.13. Acesso em: 1 out. 2026.
TYPESAFE AI. Introduction. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/introduction. Acesso em: 1 out. 2026.
TYPESAFE AI. Primitives (Questions). TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/primitives. Acesso em: 1 out. 2026.
TYPESAFE AI. System One. TypeSafe AI Documentation, 2026. Disponível em: https://docs.typesafe.ai/concepts/system-one. Acesso em: 1 out. 2026.
ZHANG, Fan et al. Same Scores, Different Decisions: Evaluating JEV and Language Models for Legal Document Understanding. arXiv, 23 set. 2026. Disponível em: https://arxiv.org/abs/2609.27678. Acesso em: 1 out. 2026.
Descubra mais sobre Régys Borges da Silveira
Assine para receber nossas notícias mais recentes por e-mail.


Dê-nos sua opinião, seu comentário ajuda o site a crescer e melhorar a qualidade dos artigos.