

Uma empresa reúne procedimentos, contratos e orientações em uma pasta e espera que a inteligência artificial encontre a resposta correta. Entretanto, três arquivos podem descrever o mesmo assunto com prazos diferentes: um está desatualizado, outro pertence a outro cliente e um terceiro só pode ser consultado pela gestão. Todos parecem relevantes para a pergunta. Encontrar um texto parecido não resolve qual deles pode sustentar a resposta.
O problema começa antes da conversa com o modelo. É preciso preparar o acervo para que cada informação carregue contexto, origem, versão e condições de acesso. Este artigo apresenta esse trabalho e um ensaio executado de recuperação com documentos inteiramente fictícios. Não vamos medir a qualidade de uma resposta gerada: vamos examinar o que chega à etapa anterior, quando o sistema escolhe quais trechos apresentar.
Se a dificuldade deixou de ser conversar com a IA e passou a ser organizar uma solução que use informações da empresa, IA Além da Conversa oferece um percurso de arquitetura, contexto, recuperação e avaliação. A degustação gratuita permite conhecer essa abordagem antes de escolher uma edição.
Recuperar informação não é aprovar seu uso
Recuperação é a seleção de registros que podem ajudar a resolver uma pergunta. Em uma busca documental, o resultado não deveria ser apenas uma frase: deveria permitir identificar o documento, localizar a passagem e conferir se ela se aplica à situação. A proposta editorial deste artigo é tratar essa seleção como uma etapa verificável, não como uma caixa de texto alimentada por qualquer arquivo disponível.
No artigo sobre RAG na prática, a recuperação aparece dentro do fluxo que busca evidências antes de gerar uma resposta. Aqui, vamos aprofundar a preparação dessas evidências. O modelo pode receber um contexto excelente ou uma mistura de orientações incompatíveis; trocar o modelo não corrige automaticamente a organização do acervo.
O paradigma é separar duas perguntas. A primeira é se um trecho tem relação com o pedido. A segunda é se ele pode ser usado por aquela pessoa, para aquela empresa e naquele período. A semelhança ajuda na primeira pergunta. As regras da aplicação e os metadados precisam participar da segunda. A revisão da resposta continua necessária depois dessas duas etapas.
Os conceitos que organizam o acervo
Um trecho, também chamado de segmento ou fragmento documental, é uma parte do documento preparada para recuperação. A segmentação, conhecida como chunking, divide o conteúdo em unidades menores. A documentação de segmentação da Microsoft apresenta diferentes técnicas, incluindo divisão por tamanho e por estrutura. A escolha depende do conteúdo e das perguntas; não existe aqui uma quantidade de palavras apresentada como ideal universal.
Metadados são os dados que descrevem o conteúdo: título, seção, empresa, versão, período de aplicação e origem, por exemplo. Um identificador distingue um documento de outro; o identificador do trecho permite localizar uma parte específica. Para um desenvolvedor, isso se aproxima de não confundir o valor de um registro com sua chave e com as condições pelas quais ele foi selecionado.
Uma representação vetorial, ou embedding, transforma texto em uma sequência de números usada na comparação entre entradas. Busca semântica é a tentativa de recuperar pelo significado aproximado, e não somente pela ocorrência das mesmas palavras. A documentação de embeddings do Ollama descreve esse uso e recomenda utilizar o mesmo modelo na indexação e na consulta. Indexar é preparar os registros que serão pesquisados.
A similaridade por cosseno é uma medida matemática de proximidade entre vetores. Neste ensaio, ela servirá para ordenar candidatos. Não é uma probabilidade de que uma política esteja vigente, nem uma nota de veracidade. Essa distinção precisa existir antes de apresentar qualquer número ao usuário.
Comece pelo inventário e preserve a origem
Minha proposta para um primeiro piloto é escolher um conjunto pequeno cujo responsável consiga revisar. Registre de onde veio cada documento, quem confirma sua aplicação, quais versões existem e quem pode consultar seu conteúdo. Uma pasta chamada “final” ou um nome contendo “novo” não substitui esse registro. O acervo precisa de uma fonte de verdade definida pela organização.
Preserve o documento original e mantenha uma ligação entre ele e os trechos derivados. Uma revisão pode corrigir um título extraído incorretamente, mas deve permitir identificar essa transformação. Se a limpeza trocar uma unidade, remover uma negação ou juntar colunas que não pertencem à mesma frase, a representação preparada pode deixar de transmitir a regra original.
A orientação de enriquecimento documental da Microsoft apresenta metadados como identificador, título e fonte, além do cuidado com transformações que alteram significado. Para este piloto, a recomendação é conservadora: não “melhore” automaticamente o texto de um procedimento como se estivesse revisando sua redação. Primeiro, confira se a extração preservou o que o responsável aprovou.
Na rotina contábil, uma orientação interna de fechamento precisa continuar distinguível de um documento do cliente e de uma norma externa. No desenvolvimento, uma decisão arquitetural deve permanecer distinguível de um comentário histórico ou de uma hipótese de investigação. Essas diferenças são propostas de classificação do acervo; não são conclusões que a busca por semelhança deva decidir sozinha.
Corte por sentido, não apenas por espaço disponível
Um trecho útil precisa conter o suficiente para que sua regra seja compreendida. Separar “não envie senhas” das informações solicitadas no atendimento pode deixar uma lista aparentemente completa sem sua restrição. Separar uma exceção da regra à qual ela se aplica pode criar uma orientação enganosa, mesmo quando todas as frases foram extraídas corretamente.
Comece pelos títulos e pelas seções existentes. No laboratório, cada seção já descreve um assunto curto, por isso foi preservada inteira. Em um documento maior, pode ser necessário dividir a seção novamente, repetindo seu título e mantendo referências à passagem anterior ou à exceção relacionada. Essa repetição de contexto não deve ser confundida com duplicar versões diferentes da mesma política.
A sobreposição de trechos repete uma pequena parte do conteúdo entre segmentos vizinhos para preservar continuidade. Ela pode ajudar, mas também aumenta o volume e traz resultados repetidos. Neste ensaio não foi aplicada sobreposição nem comparada uma estratégia com outra. O procedimento prático é testar as perguntas reais do piloto antes de estabelecer uma regra de segmentação para todo o acervo.
Não use somente o resumo de um documento como evidência de uma regra detalhada. Um resumo pode ajudar a localizar o assunto, mas uma resposta sobre prazo, condição ou exceção precisa chegar à passagem que o sustenta. Também vale conferir tabelas, notas e anexos: a unidade informativa pode ocupar mais de um parágrafo ou atravessar uma página.
Um ensaio local com versões e permissões
O ensaio foi executado em 3 de outubro de 2026, no Windows, com Node.js 25.4.0, Ollama 0.30.5 e o modelo já instalado embeddinggemma:300m. A API local produziu vetores com 768 dimensões. A ficha oficial do EmbeddingGemma descreve representações de texto e formatos de entrada distintos para consultas e documentos, aplicados neste exercício.
Foram preparados quatro documentos fictícios. O atendimento da empresa A tinha uma versão anterior, válida até setembro, e outra aplicável a partir de outubro. A empresa B tinha seu próprio procedimento. Um quarto documento da empresa A era reservado ao grupo gestão. As seções de prazo e anexos formaram seis trechos, com identificadores e metadados preservados.
Na versão antiga da empresa A, a resposta seria em até dois dias úteis; na nova, em até um dia útil. O documento da empresa B indicava quatro horas úteis, e o atendimento especial restrito à gestão, uma hora útil. Esses prazos foram inventados para tornar o conflito visível, não são recomendações de atendimento (Silveira, 2026).
A regra de seleção foi definida no código: a empresa deve corresponder à consulta, a data deve estar dentro do período registrado e o grupo deve constar entre os autorizados. O texto foi enviado ao modelo de representação vetorial, mas os filtros foram executados pelo programa. As datas e os grupos são fictícios; o exercício não implementa autenticação nem valida uma política empresarial real.
A chamada usou a API de embeddings, com truncamento desativado para não cortar silenciosamente entradas acima do limite. O executor verificou quantidade, dimensões e valores dos vetores. Não houve serviço pago, download de modelo ou envio de documentos reais. Tampouco houve geração de resposta por um modelo de linguagem.
O que os resultados mostraram
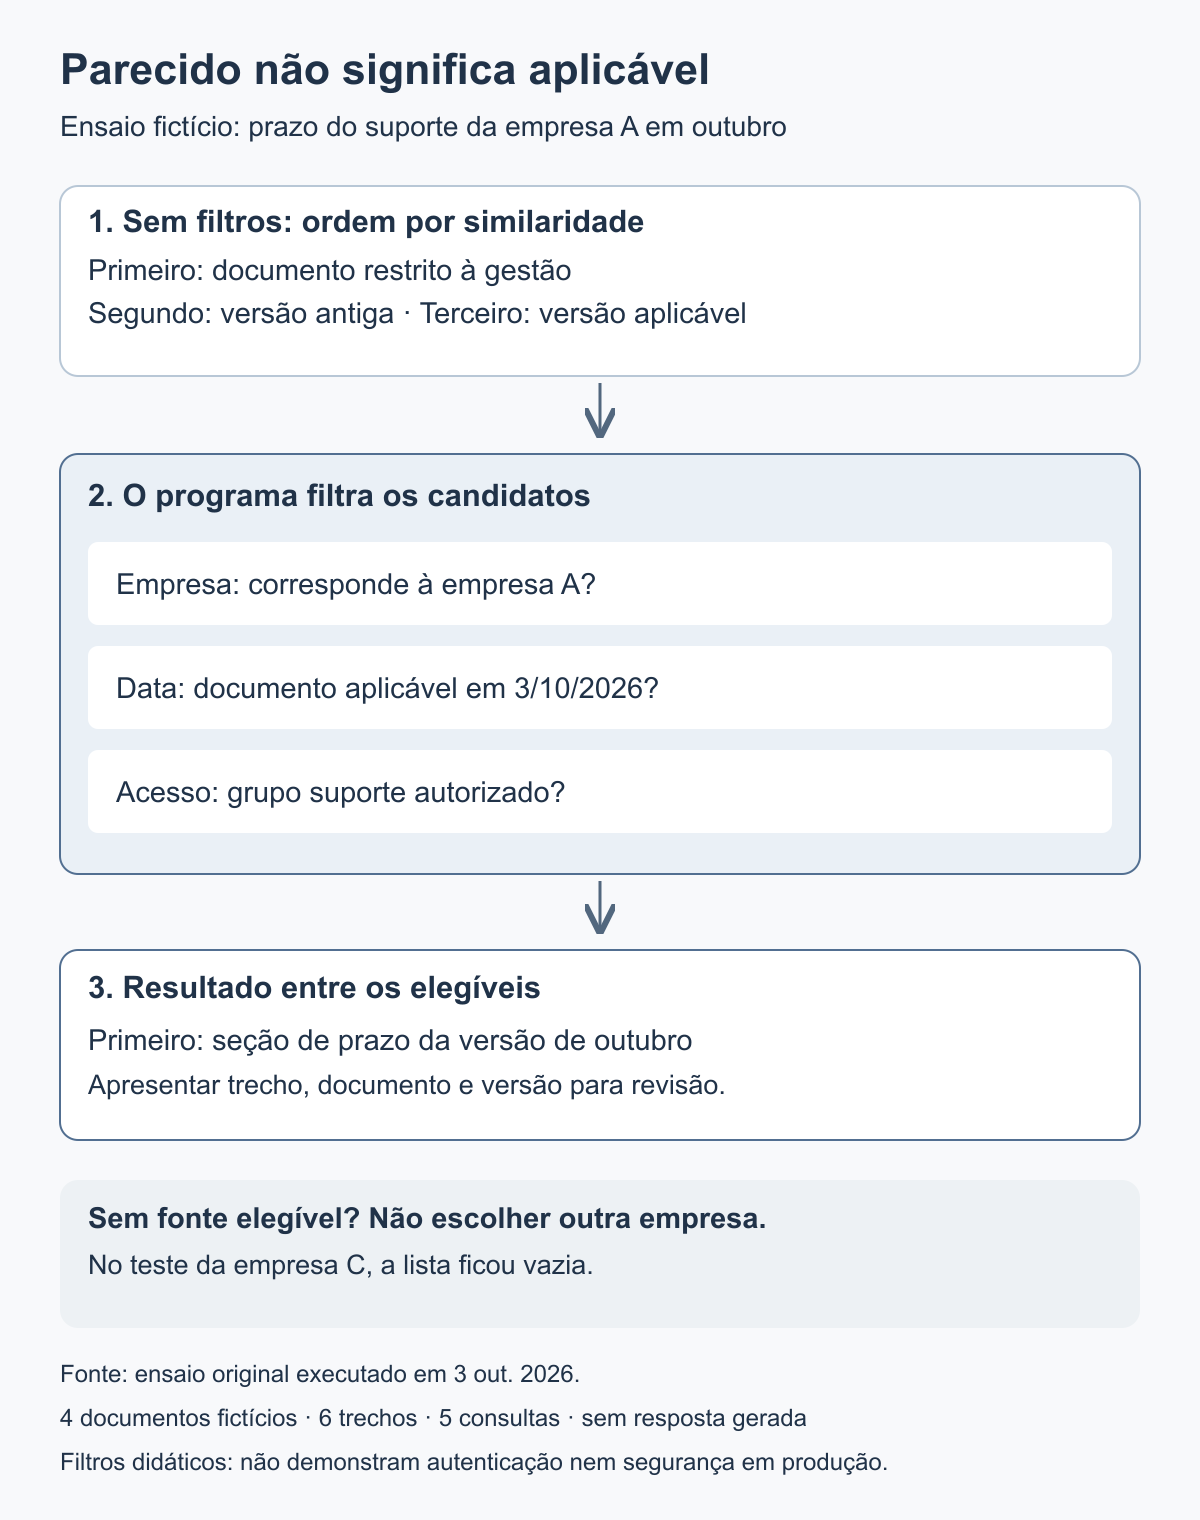
Fonte: ensaio original de recuperação executado em 3 out. 2026, descrito nesta seção. Documentos fictícios; não demonstra autenticação nem segurança em produção.
Na pergunta sobre o prazo da empresa A em outubro, a ordenação sem filtros colocou primeiro o documento restrito e depois a versão antiga. A versão aplicável apareceu em terceiro. As três pontuações estavam muito próximas. Isso mostra uma falha concreta daquele conjunto: o candidato mais semelhante não era a fonte que o usuário do grupo suporte deveria receber.
Depois dos filtros, a seção de prazo da versão de outubro ficou em primeiro lugar entre os candidatos elegíveis. Na consulta sobre anexos, foi recuperada a seção correspondente da mesma versão. Para uma pergunta histórica de setembro, a versão anterior foi selecionada. A política atual não foi usada automaticamente para responder sobre o passado.
A consulta da empresa B retornou seu procedimento, não o da empresa A. Para a empresa C, sem documento elegível no conjunto, a lista ficou vazia. O programa registrou ausência de fonte, em vez de escolher o arquivo mais parecido de outra empresa. As cinco consultas corresponderam aos resultados esperados no executor, com asserções aprovadas.
Essa evidência é pequena e delimitada. Não demonstra desempenho em milhares de arquivos, qualidade de respostas finais, segurança de autenticação ou superioridade do modelo. Demonstra que, nos casos declarados, os filtros mudaram o conjunto permitido e a recuperação encontrou os trechos esperados. Nenhuma taxa geral de acerto deve ser inferida dessas cinco perguntas.
Leve os critérios ao sistema, não ao prompt
Em um sistema Delphi, os metadados podem acompanhar os registros de documentos e seus trechos, enquanto a aplicação executa consultas e apresenta as evidências. Não é obrigatório começar por um agente autônomo. Um piloto pode simplesmente mostrar a passagem, a versão e a localização para que a pessoa confira o material antes de usar qualquer resposta gerada.
A documentação de controle de acesso documental da Microsoft ilustra a filtragem por identidade e permissões, com requisitos de sincronização próprios da plataforma. A aplicação deste artigo não usa Azure: toma esse princípio como referência e executa filtros didáticos locais. Em produção, empresa e grupo precisam vir de uma identidade autenticada e de regras confiáveis, não de campos livres preenchidos pelo solicitante.
Mudanças exigem manutenção do índice. Quando um documento for substituído, deixe de oferecer seus trechos como atuais; quando um acesso for revogado, não espere que o modelo se lembre da revogação. Confira também cópias em memória e resultados armazenados. A proposta é que atualização e exclusão tenham verificações explícitas, assim como qualquer outra mudança nos dados da aplicação.
O artigo sobre engenharia de contexto ajuda a posicionar essa preparação no trabalho maior. O acervo fornece evidências; as instruções definem a tarefa; os controles decidem o que pode ser entregue. Misturar essas funções torna difícil descobrir se uma resposta falhou por falta de informação, escolha documental ou interpretação.
Conclusão
Organizar documentos para IA significa preparar informação que possa ser selecionada e conferida, não apenas converter arquivos em texto. Um trecho precisa conservar sentido, localização, versão e condições de acesso. A recuperação por similaridade pode ajudar a encontrá-lo, mas não deve receber autoridade para decidir quais regras se aplicam ao usuário.
O ensaio mostrou uma versão antiga e um documento restrito à frente da fonte aplicável quando só a semelhança foi considerada. A ação prática é começar por perguntas representativas e verificar o caminho completo até a evidência, incluindo ausência de fonte e consultas históricas. Só depois faz sentido ampliar o acervo e acrescentar geração de respostas.
Se esse piloto levantou questões sobre como conectar recuperação, contratos e avaliação em uma solução completa, consulte o sumário de IA Além da Conversa. A leitura de amostra é um próximo passo para avaliar esse percurso, sem tratar o livro como manual de um fornecedor específico.
Referências
GOOGLE DEEPMIND. EmbeddingGemma model card. Google AI for Developers, 25 set. 2025. Disponível em: https://ai.google.dev/gemma/docs/embeddinggemma/model_card. Acesso em: 3 out. 2026.
MICROSOFT. Chunk large documents for RAG and vector search in Azure AI Search. Microsoft Learn, [s. d.]. Disponível em: https://learn.microsoft.com/en-us/azure/search/vector-search-how-to-chunk-documents. Acesso em: 3 out. 2026.
MICROSOFT. Document-level access control in Azure AI Search. Microsoft Learn, [s. d.]. Disponível em: https://learn.microsoft.com/en-us/azure/search/search-document-level-access-overview. Acesso em: 3 out. 2026.
MICROSOFT. RAG chunk enrichment phase. Microsoft Learn, 18 jun. 2026. Disponível em: https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/rag/rag-enrichment-phase. Acesso em: 3 out. 2026.
OLLAMA. Embeddings. Ollama Documentation, [s. d.]. Disponível em: https://docs.ollama.com/capabilities/embeddings. Acesso em: 3 out. 2026.
OLLAMA. Generate embeddings. Ollama Documentation, [s. d.]. Disponível em: https://docs.ollama.com/api/embed. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. Ensaio de recuperação documental com filtros de empresa, data e grupo. 2026. Programa original testar-recuperacao.mjs e registro resultado-recuperacao.md, executados localmente em 3 out. 2026. Documentos fictícios; material de pesquisa deste artigo.
SILVEIRA, Régys Borges da. IA Além da Conversa. 1. ed. 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
0 comentário(s)