

Um colaborador pergunta como solicitar a devolução de uma mercadoria. A inteligência artificial responde com segurança, enumera etapas e parece conhecer o procedimento. O problema aparece quando alguém compara a orientação com o manual da empresa: o prazo está errado e uma aprovação obrigatória desapareceu. Uma resposta bem escrita não é necessariamente uma resposta baseada na regra que realmente vale.
Depois de discutir contexto, testes e infraestrutura nesta série, chegamos ao uso de documentos internos. Este capítulo explica o conceito de RAG, acompanha o caminho entre a pergunta e a resposta e apresenta um exemplo fictício de atendimento. O objetivo não é escolher uma ferramenta por entusiasmo, mas entender quais condições permitem consultar informações empresariais com evidência e controle.
Disponibilizar documentos é apenas o começo: a aplicação precisa selecionar evidências, respeitar permissões e avaliar se a resposta corresponde à fonte. IA Além da Conversa aprofunda a recuperação de informações e sua relação com contexto, ferramentas e operação. Conheça a proposta e leia a degustação gratuita para avaliar como organizar essas decisões no seu projeto. Para outra pergunta — como um modelo aprende e gera texto — Do Zero ao LLM com Delphi oferece um laboratório educacional em Object Pascal. Recuperar conhecimento externo e estudar o treinamento de uma rede são percursos diferentes.
O conceito: recuperar antes de responder
RAG é a sigla de Retrieval-Augmented Generation, que podemos traduzir como geração aumentada por recuperação. Nesse paradigma, a aplicação procura informações externas relevantes e as fornece a um modelo de linguagem para apoiar a resposta. Um modelo de linguagem é um sistema treinado para trabalhar com sequências de texto; aqui, ele participa da redação e interpretação, enquanto a recuperação procura as evidências disponíveis.
O trabalho de Lewis e colaboradores apresenta a combinação de geração com uma memória externa recuperável, em contraste com depender apenas do conhecimento armazenado nos parâmetros do modelo. Parâmetros são os valores ajustados durante o treinamento. A pesquisa inclui treinamento dos componentes e não deve ser confundida com qualquer aplicação comercial chamada RAG (LEWIS et al., 2020). A ideia central aproveitada neste artigo é a separação entre conhecimento aprendido e informação consultada.
Em uma implementação empresarial comum, adicionar um manual ao acervo não significa treinar novamente o gerador. A aplicação prepara os documentos e recupera trechos durante a consulta. A documentação do n8n sobre recuperação de contexto descreve essa combinação de fontes externas com o modelo. Portanto, a frase “treinamos a IA com nossos PDFs” pode esconder um processo que apenas indexa e consulta arquivos.
A analogia útil é a de um profissional que consulta um manual antes de orientar um cliente. Ela tem um limite importante: o modelo não se torna responsável pelo procedimento, não verifica automaticamente a autoridade de cada documento e pode interpretar mal o trecho recebido. RAG organiza a consulta; a aplicação continua precisando decidir quem pode consultar, o que está vigente e como conferir a resposta.
Como documentos se tornam informação recuperável
Antes da pergunta, há uma preparação do acervo. Minha proposta é começar por um conjunto pequeno de documentos aprovados, com responsáveis identificados. Um arquivo abandonado em uma pasta compartilhada não deve virar regra operacional apenas porque pode ser lido. Para cada documento, registre finalidade, versão, vigência e público autorizado, além da localização original.
Os arquivos precisam ser transformados em texto utilizável. Nessa etapa, confira se tabelas, títulos e notas foram preservados. Um prazo na coluna errada pode transformar uma extração aparentemente bem-sucedida em informação enganosa. Documentos digitalizados exigem atenção adicional, pois a imagem da página e o texto extraído podem divergir. A qualidade da leitura deve entrar na revisão do acervo.
Depois, o texto pode ser dividido em trechos, chamados chunks. A intenção é recuperar uma parte pertinente sem enviar todo o acervo ao modelo. Não existe, neste artigo, um tamanho recomendado universalmente. Para um procedimento, prefiro avaliar se cada trecho preserva a condição, a regra e suas exceções. Separar uma proibição da frase que explica quando ela se aplica é uma divisão ruim, mesmo que respeite um limite numérico.
Uma forma de busca utiliza representações vetoriais, chamadas embeddings. Um vetor é uma sequência de números; neste contexto, a representação permite comparar textos segundo características aprendidas pelo modelo que a produz. Busca por similaridade procura representações próximas. Proximidade não significa identidade, verdade ou validade jurídica: uma pergunta sobre devolução pode encontrar um procedimento parecido, mas de outra unidade.
O índice é a estrutura usada para localizar candidatos à consulta. Metadados são informações associadas aos trechos, como documento de origem, seção e versão. A documentação do Qdrant sobre dados associados aos vetores demonstra armazenamento de informações adicionais e filtros. O texto original deve permanecer recuperável por associação: não se deve imaginar que o vetor seja um arquivo compactado do qual o manual será reconstruído.
Para o desenvolvedor Delphi, vale pensar em responsabilidades conhecidas: leitura dos documentos, persistência, seleção dos registros e apresentação dos resultados. A novidade está na recuperação e no uso do modelo, não na dispensa de contratos entre camadas. Cada trecho enviado precisa conservar uma identidade que permita chegar à fonte, como um registro mantém sua chave e sua origem.
O fluxo de uma pergunta até a resposta
Na consulta, minha recomendação é identificar primeiro o usuário e aplicar as regras de acesso da aplicação. A busca deve produzir somente evidências que aquele usuário possa receber. Pedir ao modelo que “não revele dados confidenciais” depois de já entregar esses dados não substitui autorização. A camada que controla os documentos precisa impedir o envio indevido.
Em seguida, a aplicação busca candidatos e avalia se eles são pertinentes. Pode haver resultados semanticamente semelhantes, mas fora da versão, da empresa ou do assunto solicitado. Quando o acervo usa representações vetoriais, a configuração da consulta precisa ser compatível com a preparação do índice. A documentação do n8n orienta usar o mesmo modelo de representação na inserção e na consulta; isso não elimina a necessidade de avaliar os resultados.
Os trechos selecionados compõem o contexto, isto é, as informações disponíveis ao modelo naquela chamada. Esse assunto foi construído no capítulo sobre engenharia de contexto para programação com IA. Agora a mesma pergunta ganha outra forma: qual evidência é necessária para responder a esta solicitação sem acrescentar dados irrelevantes?
Minha proposta de contrato de resposta exige orientação concisa, identificação das fontes e aviso quando a evidência não bastar. Contrato, aqui, é a definição verificável do que a aplicação espera receber. A existência de uma referência pode ser conferida por código; já a correspondência entre cada afirmação e o trecho citado exige avaliação de conteúdo. Uma citação inventada ou apenas decorativa não torna a resposta confiável.
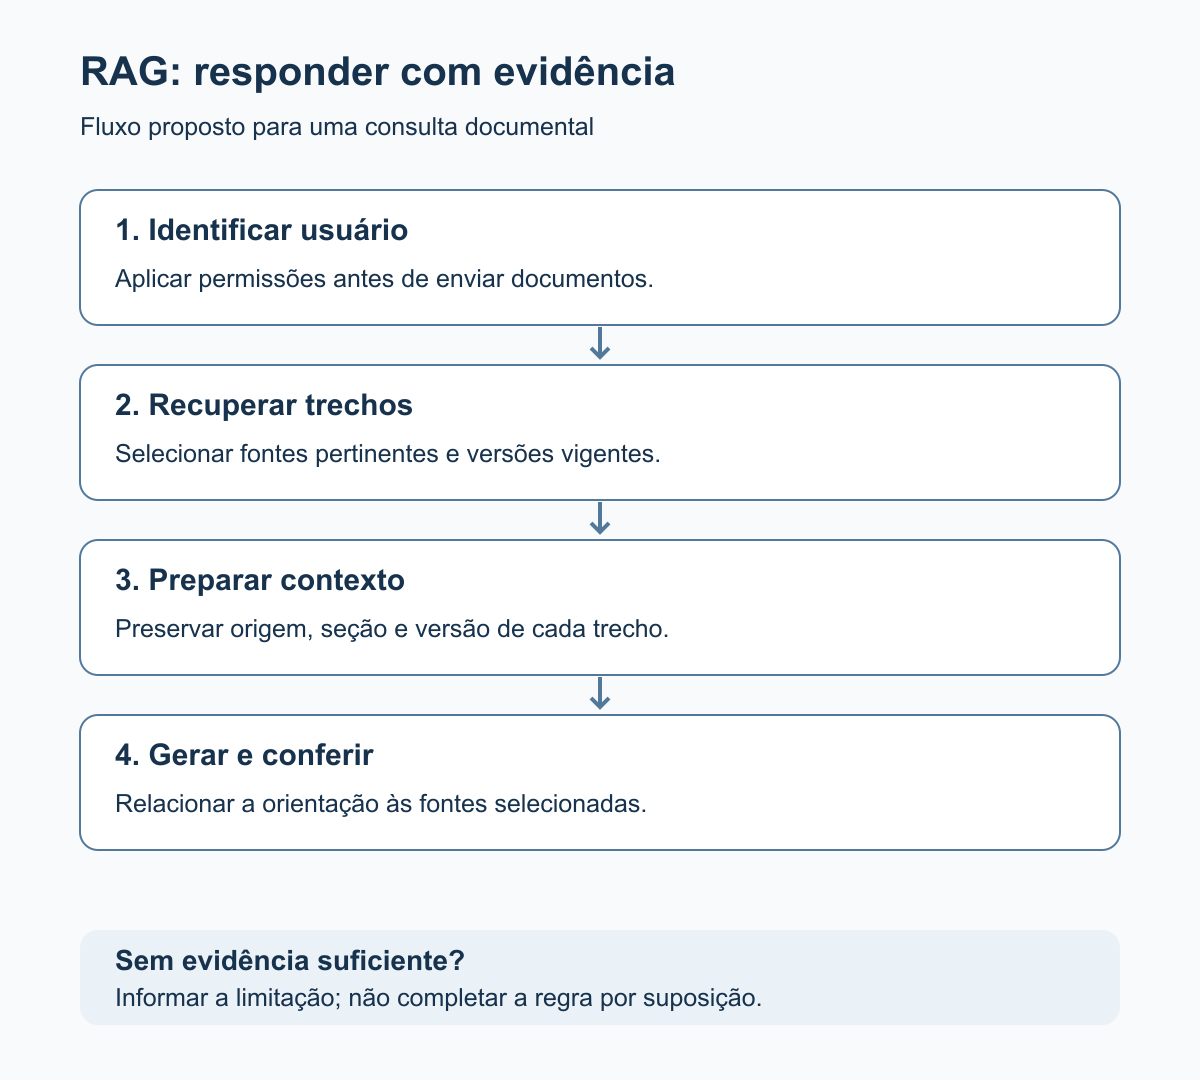
Figura — Arquitetura proposta pelo autor para uma consulta documental. A explicação textual descreve as mesmas etapas; não representa uma implementação executada.
Um exemplo empresarial, sem transformar hipótese em resultado
Considere um manual fictício, identificado como DEV-01, versão 3, seção “Solicitação”. Ele estabelece que a devolução deve ser solicitada em até sete dias corridos após o recebimento, acompanhada do número do pedido e de uma justificativa. A seção seguinte determina que mercadorias com avaria sejam encaminhadas à análise do responsável. Esses dados são exclusivamente didáticos e não descrevem legislação ou política de uma empresa real.
A pergunta é: “Recebi o pedido ontem. Posso solicitar devolução e o que preciso informar?”. Para este exemplo, a recuperação deveria localizar a seção de solicitação e preservar a identificação do manual. A resposta esperada explicaria o prazo e os dados necessários, citando DEV-01, versão 3, seção “Solicitação”. Isso mostra o uso pretendido, não um resultado medido de modelo ou ferramenta.
Agora altere a pergunta para “A empresa paga o frete de retorno?”. Se os trechos autorizados não abordarem o frete, a saída esperada deve informar essa ausência e indicar o canal responsável. Completar a resposta com uma política comum no mercado seria inadequado: o usuário perguntou sobre aquela organização, não sobre uma possibilidade genérica. A falta de evidência é um resultado que precisa ser previsto.
Uma terceira consulta, feita por usuário sem acesso ao manual, não deve receber os trechos nem uma síntese que revele suas regras. A aplicação pode encaminhar a solicitação a um responsável autorizado, conforme sua política. Observe que a pergunta pode ser perfeitamente legítima e ainda assim estar fora do acesso daquele usuário. Relevância e autorização são critérios diferentes.
Também é necessário testar versões conflitantes. Se o índice ainda contiver uma versão anterior com prazo diferente, a aplicação não deve deixar que a escolha seja determinada apenas pela similaridade. No cenário proposto, vigência e autoridade documental fazem parte da seleção. Quando a regra de precedência não estiver definida, o comportamento esperado é sinalizar a divergência, e não escolher silenciosamente uma resposta.
Quando usar e quando procurar outra solução
RAG merece avaliação quando a tarefa exige responder com base em documentos consultáveis: manuais de suporte, procedimentos internos e orientações de uso de um produto são exemplos possíveis. Minha recomendação é priorizar perguntas recorrentes com fontes identificáveis. Isso permite comparar a resposta com uma referência e detectar onde o processo falha.
Se a necessidade for apenas localizar uma seção, uma busca convencional com apresentação do trecho pode ser suficiente. Se a tarefa exigir o saldo atual de um cliente, prefiro uma consulta autorizada ao sistema responsável, e não uma cópia documental que talvez esteja desatualizada. Se envolver cálculo ou mudança de cadastro, a regra determinística e a operação do sistema continuam essenciais.
A execução local ou remota não altera essas responsabilidades. No capítulo sobre IA local ou na nuvem, discutimos dados, infraestrutura e operação. Para RAG, a análise precisa abranger também onde ficam os documentos, o índice e os registros das consultas, não somente onde o gerador responde.
O benefício pretendido é aproximar a resposta das fontes pertinentes. A contrapartida é manter uma nova cadeia operacional: preparação, atualização, recuperação, permissões e avaliação. Um piloto pequeno pode ser mais útil do que importar todo o arquivo da empresa. Não apresento ganhos de precisão, economia ou produtividade, pois este artigo não executou uma avaliação empírica de RAG.
Como avaliar antes de colocar em produção
Monte perguntas com respostas esperadas e fontes aprovadas. Inclua casos respondíveis, perguntas sem resposta, documentos conflitantes e usuários com acessos diferentes. Minha proposta é avaliar recuperação e geração separadamente: o trecho correto chegou ao contexto? A resposta respeitou esse trecho? Essa divisão ajuda a não atribuir ao modelo um erro que começou na seleção.
Registre também custo operacional e tempo de resposta, além das falhas. O responsável pelo processo deve revisar os casos relevantes, sobretudo quando uma orientação errada puder causar prejuízo. Nenhum percentual isolado deve esconder erros críticos. Os critérios de aceitação precisam refletir a aplicação: um assistente de navegação em manuais e uma orientação operacional sensível não têm o mesmo risco.
Há ainda a injeção de instruções (prompt injection), tentativa de fazer o modelo obedecer a comandos inseridos no conteúdo que ele consulta. A OWASP alerta que RAG não elimina essa vulnerabilidade. Um documento recuperado deve ser tratado como dado externo, não como autorização para mudar regras da aplicação ou acionar ferramentas.
Por isso, proponho começar com consultas sem ações externas, manter permissões fora do modelo e revisar a procedência dos documentos. Esse arranjo não promete segurança absoluta, mas limita o alcance do piloto e torna suas falhas mais observáveis. Conectar a consulta a ferramentas de um ERP será um passo separado, com controles próprios, no próximo capítulo da série.
Conclusão
Fazer a IA responder usando documentos da empresa exige mais do que disponibilizar arquivos. O paradigma de RAG acrescenta uma etapa explícita de recuperação, mas a qualidade depende do acervo, da seleção, das permissões e da correspondência entre resposta e evidência. O modelo não transforma um documento desatualizado em uma regra válida.
O primeiro passo prático é escolher um procedimento pequeno, identificar sua fonte e definir perguntas que a aplicação deve responder — e outras que deve reconhecer como não respondíveis. Quando essa avaliação puder ser repetida com clareza, haverá uma base melhor para ampliar o acervo. A resposta útil não é a que sempre encontra algo para dizer, mas a que permite verificar de onde veio a orientação e onde termina sua sustentação.
Quando o primeiro conjunto de documentos começar a crescer, a recuperação precisará fazer parte de uma arquitetura de conhecimento, com fontes rastreáveis e critérios de avaliação. IA Além da Conversa aprofunda embeddings, recuperação e sua relação com permissões e operação. Confira o sumário e a degustação gratuita para avaliar esse próximo passo além da demonstração inicial.
Referências
LEWIS, Patrick et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv, 2020. Versão consultada: v4, 2021. Disponível em: https://arxiv.org/html/2005.11401v4. Acesso em: 2 out. 2026.
N8N. Retrieve relevant context. n8n Docs, [s. d.]. Disponível em: https://docs.n8n.io/build/integrate-ai/understand-ai-components/retrieve-relevant-context. Acesso em: 2 out. 2026.
OWASP FOUNDATION. LLM01:2025 Prompt Injection. OWASP Gen AI Security Project, 2025. Disponível em: https://genai.owasp.org/llmrisk/llm01-prompt-injection/. Acesso em: 2 out. 2026.
QDRANT. Payload. Qdrant Documentation, [s. d.]. Disponível em: https://qdrant.tech/documentation/manage-data/payload/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Do Zero ao LLM com Delphi. Livros de Régys Borges da Silveira, [s. d.]. Disponível em: https://livros.regys.com.br/do-zero-ao-llm-com-delphi. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. Engenharia de contexto: por que um bom prompt não basta para programar com IA. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/engenharia-de-contexto-por-que-um-bom-prompt-nao-basta-para-programar-com-ia/. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. Livros de Régys Borges da Silveira, [s. d.]. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 2 out. 2026.
SILVEIRA, Régys Borges da. IA local ou na nuvem: o que muda em custo, privacidade e desempenho. regys.com.br, [s. d.]. Disponível em: https://regys.com.br/ia-local-ou-na-nuvem-o-que-muda-em-custo-privacidade-e-desempenho/. Acesso em: 2 out. 2026.
0 comentário(s)