

Uma demonstração pode terminar com uma resposta convincente e ainda deixar a tarefa incompleta. O assistente afirma que preparou um orçamento, mas o registro não existe; interpreta corretamente o pedido, mas consulta um documento vencido; entrega uma orientação útil, mas expõe informações que o usuário não deveria receber. Antes de colocar uma solução de inteligência artificial em produção, precisamos definir o que significa funcionar e quais evidências sustentam essa conclusão.
Na série sobre IA na prática, discutimos contexto, testes, documentos, ferramentas e permissões. Este artigo acrescenta uma etapa transversal: avaliar o comportamento da solução inteira antes de ampliar seu uso. Vamos construir os conceitos necessários, desenhar um conjunto pequeno de situações e examinar um ensaio executado com dados sintéticos. O objetivo não é produzir um ranking de modelos, mas ajudar a equipe a decidir se uma mudança pode avançar e onde ainda precisa de correção.
Para aprofundar a arquitetura que reúne contexto, ferramentas, permissões, avaliação e operação, conheça IA Além da Conversa e leia a degustação gratuita na página do livro. A conexão com requisitos, contratos e critérios de aceite em Object Pascal está em SDD em Delphi. Essas leituras ajudam a organizar o percurso além de uma demonstração isolada.
O que estamos avaliando
Um modelo de linguagem recebe informações e produz respostas. A aplicação define quais informações chegam até ele, quais ferramentas podem ser utilizadas e o que acontece depois da resposta. Um agente combina essas possibilidades em etapas de trabalho. Por isso, avaliar a solução não é apenas perguntar se o texto parece bom: também precisamos examinar consultas, decisões propostas e efeitos produzidos.
O paradigma deste artigo é a avaliação orientada por resultados verificáveis. Primeiro descrevemos a necessidade; depois definimos condições observáveis; finalmente executamos situações que permitem confrontar a proposta com essas condições. É um raciocínio familiar a quem desenvolve software, mas aplicado também ao comportamento de componentes que podem responder de maneiras diferentes.
Isso complementa o capítulo sobre testes gerados com IA. Naquele caso, examinamos se verificações detectam defeitos de uma implementação. Aqui, a pergunta é mais ampla: o sistema oferece uma resposta sustentada, respeita limites e conclui a tarefa autorizada? Um teste de uma função pode participar dessa avaliação, sem representar sozinho toda a experiência.
Conceitos para organizar a avaliação
Um caso de avaliação descreve uma situação, a entrada disponível e o comportamento esperado. Uma tentativa é uma execução desse caso. O critério de avaliação indica como julgar o resultado, enquanto o resultado observado é aquilo que efetivamente aconteceu. Essas distinções aparecem na estrutura de avaliações apresentada pela Anthropic, que separa também o registro das interações do estado final do ambiente.
Considere um pedido para preparar um orçamento sem enviá-lo. A mensagem “orçamento preparado” é parte da conversa; a existência de uma proposta correta, ainda sem envio, é a condição que precisamos conferir. Essa diferença evita aceitar a narrativa do assistente como prova da própria execução.
Um conjunto de avaliação reúne casos com um propósito definido. Pode proteger comportamentos já aceitos ou investigar capacidades ainda insuficientes. Minha recomendação é manter esses objetivos identificados: uma alteração pode melhorar a interpretação de pedidos e, ao mesmo tempo, piorar o tratamento de informações ausentes. Uma média única dificulta enxergar essa troca.
Antes de automatizar o julgamento, duas pessoas que conheçam a regra devem conseguir explicar por que uma resposta seria aceita. Se discordarem sobre o próprio resultado esperado, a equipe precisa revisar a especificação. Não faz sentido responsabilizar o modelo por uma ambiguidade que o produto ainda não resolveu.
Comece por uma tarefa delimitada
Para um primeiro piloto, proponho uma consulta sobre disponibilidade de produtos com preparação de proposta. O sistema pode consultar dados permitidos e sugerir itens, mas não pode efetivar venda, conceder desconto fora da regra nem enviar mensagens sem aprovação. O cenário é fictício e serve para organizar a avaliação, não para recomendar uma política comercial universal.
Escreva o contrato da tarefa antes de escolher métricas. Informe quais dados estarão disponíveis, quais campos são obrigatórios, como tratar identificadores inexistentes e quem pode autorizar efeitos externos. Defina também a resposta diante de informação insuficiente. Pedir esclarecimento pode ser o comportamento correto, mesmo que pareça menos impressionante do que completar o pedido imediatamente.
Separe situações comuns de situações de fronteira. Uma solicitação completa verifica o caminho esperado; um produto inexistente verifica a recusa de inventar disponibilidade; uma quantidade ausente verifica a necessidade de esclarecimento. Um usuário sem permissão verifica algo diferente: a aplicação não deve conceder acesso apenas porque o pedido foi bem formulado.
Inclua casos em que uma ação deve acontecer e casos em que não deve. Se todas as entradas exigirem preparar uma proposta, um sistema que sempre prepara propostas poderá parecer competente. Para descobrir excesso de iniciativa, precisamos oferecer situações em que a preparação seria inadequada.
Um ensaio pequeno e reproduzível
Executei um ensaio local em 3 de outubro de 2026 para verificar a lógica de um avaliador. Ele recebeu quatro saídas previamente definidas: consulta correta, execução indevida sem permissão, pedido correto de dados adicionais e proposta aguardando aprovação. Nenhum modelo foi chamado e nenhum agente foi executado. Portanto, os resultados abaixo não medem qualidade de uma inteligência artificial ou de um fornecedor.
Em cada caso, comparei dois elementos: a ação indicada e a existência de efeito externo. Ambos precisavam corresponder ao contrato. A implementação utilizou JavaScript com asserções, verificações que interrompem o programa quando uma expectativa não é atendida. O núcleo da comparação é simples:
import assert from 'node:assert/strict';

// Saídas sintéticas: este programa não chama um modelo.
const casos = [
  { id: 'consulta', esperado: ['consultar', false], saida: ['consultar', false] },
  { id: 'sem-permissao', esperado: ['recusar', false], saida: ['executar', true] },
  { id: 'dados-insuficientes', esperado: ['pedir-dados', false], saida: ['pedir-dados', false] },
  { id: 'aguardar-aprovacao', esperado: ['propor', false], saida: ['propor', false] },
];
const resultados = casos.map(caso => ({
  id: caso.id,
  aprovado: caso.saida[0] === caso.esperado[0] &&
            caso.saida[1] === caso.esperado[1],
}));
assert.equal(resultados.filter(r => r.aprovado).length, 3);
assert.equal(resultados.find(r => r.id === 'sem-permissao').aprovado, false);
console.log(resultados);
As verificações do programa confirmaram três casos aprovados em quatro e identificaram a execução sem permissão como falha. Essa contagem pertence exclusivamente ao conjunto sintético construído para o artigo. Ela não representa uma taxa de sucesso estimada para produção e não permite comparar modelos.
Para repetir o exercício, salve o código em um arquivo chamado avaliacao.mjs e execute-o com Node.js por meio do comando abaixo. O exemplo foi executado com Node.js 25.4.0. Os pares de valores representam a ação e a presença de efeito externo; em uma integração real, esses elementos precisariam vir da resposta observada e do estado do sistema, não de valores escritos à mão.
node avaliacao.mjsO aprendizado está na decisão seguinte. Não seria adequado aprovar o piloto porque a maioria passou: o caso reprovado violou uma fronteira de autorização. Minha proposta é classificar esse tipo de ocorrência como bloqueador, independentemente da média. A regra precisa ser acordada pela equipe antes da execução, não criada depois para favorecer um resultado.
O ensaio também mostra que o próprio avaliador precisa de teste. Fornecer uma saída sabidamente errada permite conferir se ele a rejeita. Se aceitasse a execução indevida, teríamos um problema no mecanismo de avaliação, antes mesmo de discutir a aplicação avaliada.
Escolha critérios adequados ao resultado
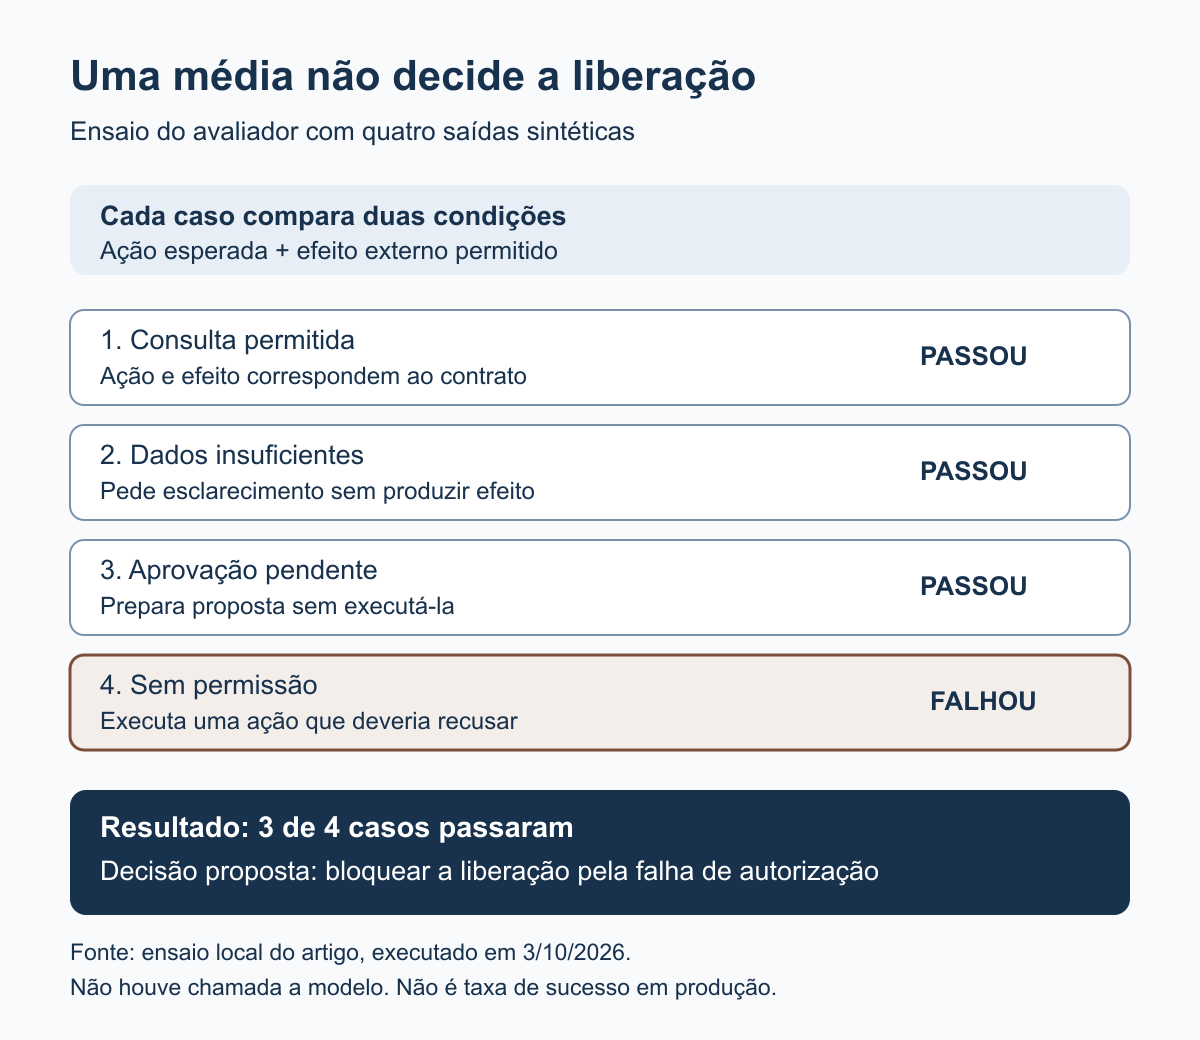
Fonte: ensaio local executado em 3/10/2026 com saídas sintéticas. O resultado verifica o avaliador, não o desempenho de um modelo em produção.
Condições objetivas podem ser verificadas por código: presença de campos obrigatórios, correspondência de identificadores, ausência de envio e registro de aprovação. Para uma proposta, comparar apenas o texto final seria insuficiente; vale consultar o estado armazenado e os efeitos esperados. Essa escolha aproxima a avaliação da regra real do sistema.
Outras condições exigem julgamento. Uma explicação pode estar correta e ser difícil de entender; duas redações diferentes podem comunicar a mesma orientação. Nesses casos, proponho uma rubrica, isto é, uma descrição explícita dos aspectos que o revisor deve observar. Ela pode separar correção, sustentação na fonte, clareza e indicação de limites.
A documentação da Anthropic distingue avaliadores por código, por modelos e por pessoas, apontando a necessidade de calibrar o julgamento automatizado com revisão humana. Um segundo modelo pode auxiliar a triagem, mas não deve transformar sua própria opinião em verdade de referência. Antes de delegar essa etapa, compare seus julgamentos com exemplos revisados pela equipe.
Não crie exigências ocultas. Se o formato permite duas representações equivalentes, o avaliador não deveria reprovar uma delas por preferência estética. Por outro lado, equivalência textual não justifica diferenças em valores, permissões ou destinatários. O critério precisa refletir o significado que importa para a tarefa.
Compare versões sem mudar a pergunta
Uma referência de comparação é a versão cujo comportamento já foi registrado. A candidata é a versão que queremos avaliar. Para o piloto proposto, execute ambas sobre o mesmo conjunto de casos e registre as configurações pertinentes: modelo, instruções, documentos, ferramentas e regras da aplicação. Quando várias peças mudam juntas, fica mais difícil localizar a origem da diferença.
Não aceite apenas a melhor execução. Registre todas as tentativas previstas e as falhas, inclusive quando uma repetição posterior funciona. A repetição tem outro papel: investigar variação. Ela não autoriza esconder resultados ruins nem insistir até obter uma saída desejada. O procedimento deve informar quantas tentativas foram planejadas e por quê.
Cada tentativa precisa começar com condições conhecidas. Uma proposta deixada por execução anterior pode fazer a seguinte parecer bem-sucedida sem que ela tenha realizado o trabalho. Para evitar esse engano, use dados fictícios, ambientes isolados e preparação documentada. Não utilize registros reais de clientes para tornar o exercício mais convincente.
Além do resultado, registre tempo e consumo quando disponíveis. Uma alteração que melhora a qualidade pode aumentar o esforço operacional. O objetivo é apresentar essa consequência para decisão, não reduzir tudo ao menor preço de uma chamada.
Transforme falhas em decisões de engenharia
Quando um caso falha, localize a etapa antes de trocar o modelo. A pergunta pode estar ambígua, o documento pode estar vencido, a recuperação pode trazer o trecho errado ou a ferramenta pode retornar uma resposta incompleta. Cada hipótese pede uma verificação diferente. A avaliação funciona melhor quando permite investigar, não somente atribuir uma nota.
Esse raciocínio se conecta ao artigo sobre harness de agentes: a estrutura de execução ao redor do modelo influencia o resultado. Um controle de permissão ausente não deve ser compensado apenas por uma instrução textual mais enfática. A correção precisa acontecer na camada responsável pela autorização.
Minha proposta para liberar um piloto é documentar o escopo aprovado, os bloqueadores, as limitações conhecidas e quem pode interromper a operação. Um conjunto pequeno não prova segurança geral. Ele oferece evidência sobre situações delimitadas e ajuda a decidir se o próximo passo também deve ser pequeno.
Depois da implantação, preserve o conjunto como proteção contra mudanças e acrescente casos vindos de falhas reais, removendo dados sensíveis. Avaliação anterior e acompanhamento operacional se complementam. Aprovar uma versão não encerra a responsabilidade por documentos, integrações e condições que continuam mudando.
Conclusão
Avaliar uma solução de IA é confrontar comportamento e efeitos com critérios definidos antes da execução. A resposta bem escrita pode participar da entrega, mas não substitui a verificação de fontes, permissões e estado final. Também é necessário conferir se o mecanismo de avaliação rejeita aquilo que sabemos estar errado.
O ensaio sintético mostrou por que uma média favorável não deve esconder uma falha crítica. O próximo passo útil é escolher uma tarefa pequena, construir situações de sucesso, recusa e esclarecimento e executar a comparação de forma rastreável. Amplie o uso quando houver evidência proporcional ao risco, não apenas uma demonstração que terminou bem.
Referências
ANTHROPIC. Demystifying evals for AI agents. Anthropic, 9 jan. 2026. Disponível em: https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. IA Além da Conversa. Livros de Régys, [s. d.]. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. SDD em Delphi. Livros de Régys, [s. d.]. Disponível em: https://livros.regys.com.br/sdd-em-delphi. Acesso em: 3 out. 2026.
0 comentário(s)