

A demonstração funciona, mas a rotina traz perguntas diferentes. Por que o atendimento demorou tanto? O custo aumentou porque houve mais pedidos ou porque cada pedido passou a consumir mais recursos? A integração respondeu sem erro de conexão, mas entregou algo que o sistema não pôde aceitar. Sem registros adequados, essas situações parecem um único problema: “a IA não está funcionando bem”.
Este artigo mostra como separar consumo, tempo e resultado para investigar a operação. O percurso começa pelos conceitos, apresenta um exercício determinístico com dados fictícios e termina com critérios para uma aplicação empresarial. Não há comparação de desempenho entre fornecedores nem medição de um modelo: o exemplo testa a interpretação dos registros e seus limites.
Para aprofundar o desenho de soluções que precisam operar além da demonstração, conheça IA Além da Conversa. O livro inclui custos, desempenho, observabilidade e avaliação; sua degustação gratuita ajuda a conhecer a abordagem antes de escolher uma edição.
Observar não é apenas contar erros
Telemetria é o conjunto de dados emitidos por um sistema sobre sua execução. Observabilidade é a capacidade de usar esses sinais para entender o que está acontecendo e investigar suas causas. A introdução do OpenTelemetry explica essa relação e lembra que um serviço disponível pode não realizar aquilo que o usuário espera. Em uma integração com IA, receber uma resposta não significa concluir corretamente a tarefa.
Três sinais ajudam nessa investigação. Registros de eventos (logs) descrevem ocorrências específicas, como uma solicitação rejeitada na validação. Métricas agregam medidas, como quantidade de falhas em um período. Rastreamentos (traces) relacionam as etapas de uma operação; cada trecho acompanhado, chamado intervalo de operação (span), pode mostrar onde começou e terminou uma atividade.
Esses nomes não exigem começar com uma plataforma grande. Uma aplicação pequena pode registrar eventos estruturados e medidas por etapa, desde que a equipe consiga relacioná-los e responder a perguntas úteis. O instrumento deve servir ao diagnóstico. Acumular milhares de linhas sem identificação da operação ou motivo da falha apenas transfere a dificuldade para outro lugar.
Para quem trabalha com Delphi, o ponto de partida é separar preparação, consulta de fontes, chamada externa e validação. O artigo sobre engenharia de contexto explica por que o pedido não vive isolado. Na operação, essa separação também permite descobrir qual componente passou a consumir tempo ou produzir dados inadequados.
Meça a tarefa e cada tentativa
Uma tarefa do usuário pode exigir várias chamadas. Se a primeira não termina dentro do prazo e a aplicação tenta novamente, contar somente a resposta final esconde parte da espera. Também esconde que a recuperação ocorreu depois de uma falha. Registre a operação lógica e suas tentativas sem confundir uma medida com a outra.
As convenções de intervalos GenAI do OpenTelemetry orientam que a duração da operação lógica inclua suas novas tentativas. Essa fonte está em desenvolvimento na consulta de 3 de outubro de 2026; seus nomes e detalhes não devem ser tratados como contrato imutável. O exercício deste artigo usa campos próprios, não implementa instrumentação OpenTelemetry.
Latência é o tempo entre iniciar uma atividade e observar seu resultado. Declare os limites da medida: tempo de uma chamada não é necessariamente o tempo percebido pelo usuário. Busca, fila, espera entre tentativas e validação também participam da experiência. Em etapas simultâneas, não some durações como se todas fossem sequenciais; use os instantes de início e fim para compreender sobreposições.
Se a interface recebe a resposta em partes, o tempo até a primeira parte e o tempo até a conclusão respondem a perguntas distintas. As convenções de métricas GenAI distinguem medidas da operação e da chegada de partes da resposta. Uma apresentação que começa rapidamente ainda pode demorar para fornecer tudo o que a tarefa exige.
Custo estimado não é a fatura
Tokens são unidades usadas pelo modelo para representar o conteúdo processado e gerado; não equivalem automaticamente a palavras. Para estimar consumo, registre as quantidades informadas pelo serviço e a versão da tarifa aplicada. Não deduza o valor cobrado apenas pelo comprimento do texto visível.
O exercício adota uma unidade monetária fictícia, UM, com tarifas de 2 UM por milhão de tokens de entrada e 8 UM por milhão de tokens de saída. Esses valores foram escolhidos exclusivamente para demonstrar a conta e não representam preço de fornecedor. Uma tentativa com 1.000 tokens de entrada e 200 de saída resulta em 0,0036 UM, pela soma dos dois consumos multiplicados por suas tarifas (Silveira, 2026).
Essa conta cobre apenas os itens definidos no exemplo. Uma implementação real precisa considerar as regras comerciais efetivamente contratadas, recursos adicionais e diferenças entre estimativa e faturamento. Custos de infraestrutura, armazenamento e manutenção não desaparecem por não estarem na cobrança do modelo. Não inclua parcelas que você não mediu como se fossem conhecidas.
Quando uma chamada falha antes de retornar os dados de uso, o consumo pode permanecer desconhecido. O valor conhecido das demais tentativas não se transforma no custo completo da tarefa. Preserve essa incompletude no relatório e investigue-a pela fonte de faturamento disponível. No exercício, um campo específico informa se todas as tentativas possuem consumo registrado.
Quatro tarefas, cinco tentativas: um exercício executado
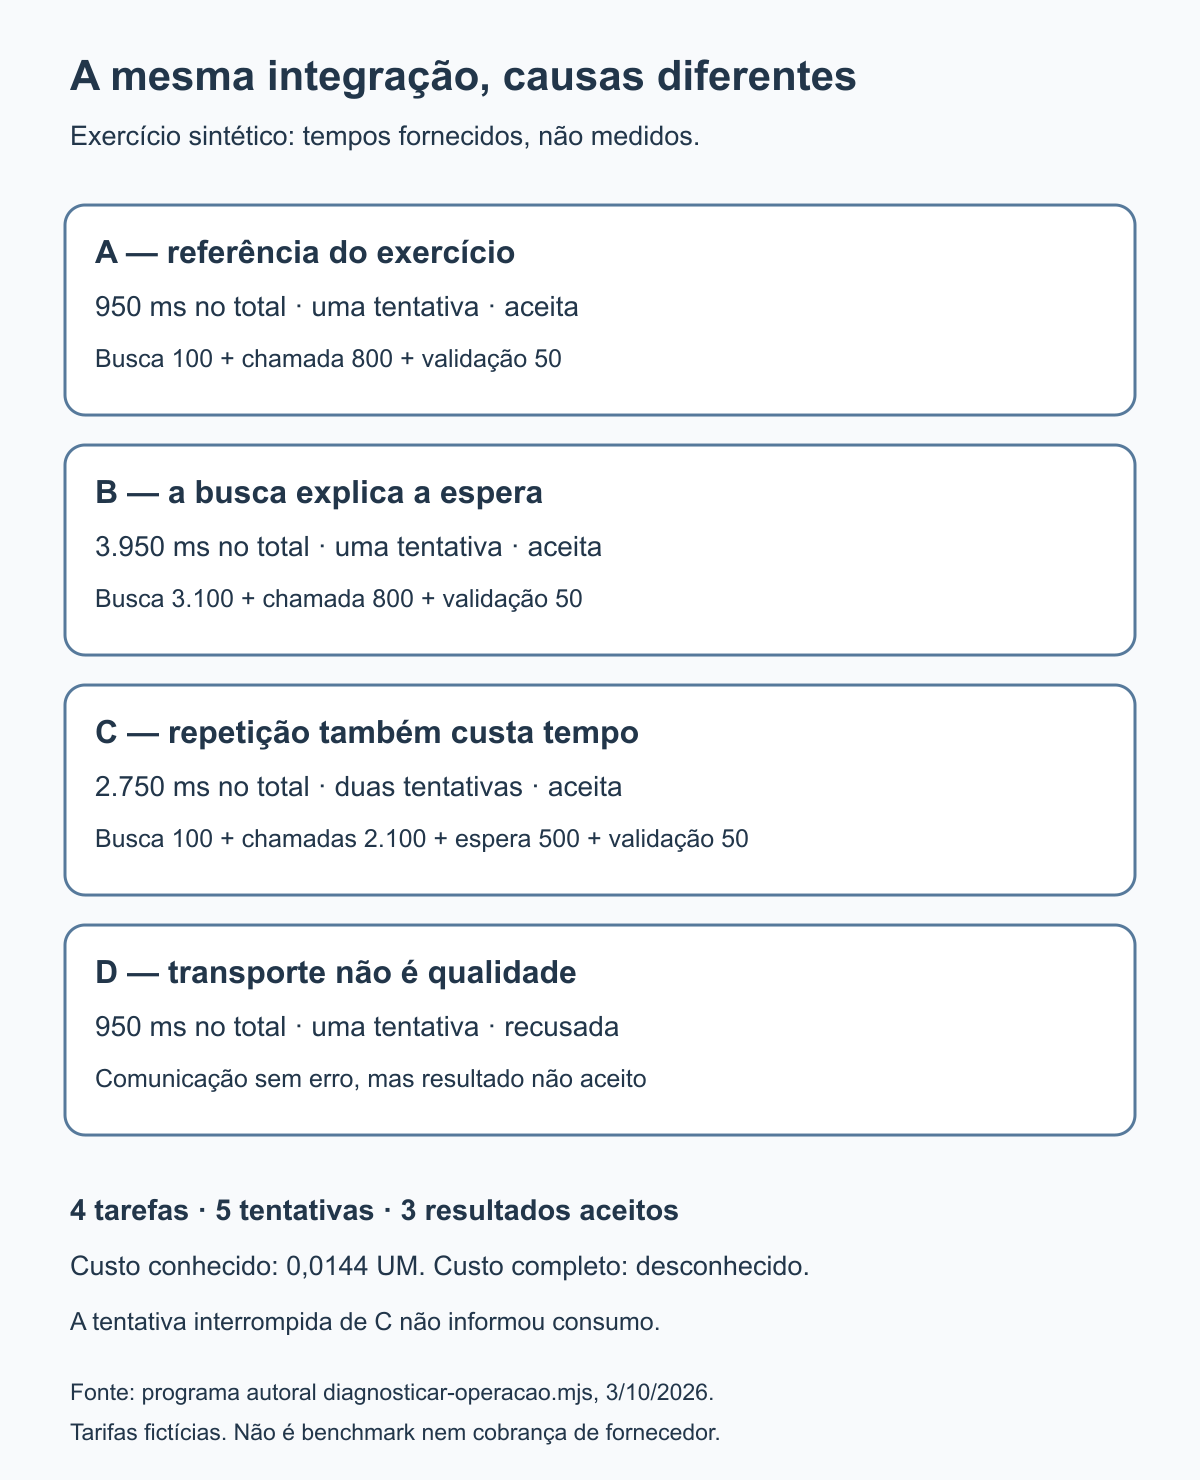
Fonte: ensaio autoral com o programa diagnosticar-operacao.mjs (Silveira, 2026). Tempos e tarifas fictícios; não são medições de um serviço ou cobrança real.
Foi criado e executado um pequeno programa em JavaScript com quatro tarefas sintéticas. Ele contém os registros no próprio arquivo, calcula durações e estimativas e verifica os resultados por asserções, isto é, condições que interrompem a execução se uma expectativa não for satisfeita. Nenhum modelo ou serviço pago foi chamado. Os tempos, consumos e avaliações de aceite são dados de entrada fictícios, não observações de produção.
Na tarefa A, busca de 100 milissegundos, chamada de 800 e validação de 50 produzem 950 milissegundos de duração total. Na tarefa B, a chamada continua com 800, mas a busca exige 3.100; o total passa a 3.950. Trocar o modelo não é a primeira hipótese sustentada por esses registros: a diferença está na recuperação do material (Silveira, 2026).
Na tarefa C, a primeira tentativa termina por limite de espera, representado pelo identificador timeout, após 1.200 milissegundos. Há uma espera de 500 antes de uma segunda tentativa de 900. Com busca e validação, a tarefa termina em 2.750. O consumo da tentativa interrompida foi marcado como desconhecido; o relatório não o transforma em zero, embora calcule separadamente o valor conhecido (Silveira, 2026).
A tarefa D termina com a mesma duração de A e sem falha de transporte, mas seu resultado é recusado. Essa marca de aceite foi definida nos dados sintéticos, não produzida por um avaliador de linguagem. Ela demonstra uma distinção operacional: funcionamento da comunicação e aprovação da tarefa devem ser campos independentes.
No conjunto, há cinco tentativas, uma falha de transporte por tentativa e três tarefas aceitas entre quatro. A proporção de falhas é 1/5, ou 20%; isso não significa que 20% das tarefas terminaram em erro. O custo conhecido soma 0,0144 UM e o custo completo continua indeterminado. As asserções conferiram esses resultados e terminaram sem erro (Silveira, 2026). A amostra serve ao ensino, não à previsão de confiabilidade.
Da medida à decisão de operação
Para reproduzir o exercício, salve o código abaixo como diagnosticar-operacao.mjs e execute node diagnosticar-operacao.mjs. Foi executado com Node.js 25.4.0; utiliza apenas recursos nativos, sem instalação de pacotes. As verificações comprovam a interpretação desses dados sintéticos, não coletam telemetria nem avaliam respostas de um modelo.
import assert from 'node:assert/strict';

// Dados e tarifas fictícios. Não há chamada a modelo ou coleta em produção.
const tarefas = [
  { id: 'a', buscaMs: 100, esperaMs: 0, validacaoMs: 50,
    tentativas: [{ ms: 800, entrada: 1000, saida: 200, erro: null }], aceita: true },
  { id: 'b', buscaMs: 3100, esperaMs: 0, validacaoMs: 50,
    tentativas: [{ ms: 800, entrada: 1000, saida: 200, erro: null }], aceita: true },
  { id: 'c', buscaMs: 100, esperaMs: 500, validacaoMs: 50,
    tentativas: [{ ms: 1200, entrada: null, saida: null, erro: 'timeout' },
      { ms: 900, entrada: 1000, saida: 200, erro: null }], aceita: true },
  { id: 'd', buscaMs: 100, esperaMs: 0, validacaoMs: 50,
    tentativas: [{ ms: 800, entrada: 1000, saida: 200, erro: null }], aceita: false },
];
const tarifa = { entradaPorMilhao: 2, saidaPorMilhao: 8, unidade: 'UM fictícia' };
const linhas = tarefas.map(t => {
  const chamadasMs = t.tentativas.reduce((s, x) => s + x.ms, 0);
  const custoConhecido = t.tentativas.reduce((s, x) =>
    s + (x.entrada === null || x.saida === null ? 0 :
      (x.entrada * tarifa.entradaPorMilhao + x.saida * tarifa.saidaPorMilhao) / 1e6), 0);
  return { id: t.id, totalMs: t.buscaMs + t.esperaMs + chamadasMs + t.validacaoMs,
    buscaMs: t.buscaMs, chamadasMs, tentativas: t.tentativas.length,
    errosTransporte: t.tentativas.filter(x => x.erro !== null).length,
    aceita: t.aceita, custoConhecido,
    custoCompleto: t.tentativas.every(x => x.entrada !== null && x.saida !== null) };
});
assert.deepEqual(linhas.map(x => x.totalMs), [950, 3950, 2750, 950]);
assert.equal(linhas[1].buscaMs, 3100);
assert.equal(linhas[2].tentativas, 2);
assert.equal(linhas[2].custoCompleto, false);
assert.equal(linhas[3].errosTransporte, 0);
assert.equal(linhas[3].aceita, false);
const tentativas = linhas.reduce((s, x) => s + x.tentativas, 0);
const falhas = linhas.reduce((s, x) => s + x.errosTransporte, 0);
const custoConhecido = linhas.reduce((s, x) => s + x.custoConhecido, 0);
assert.equal(tentativas, 5);
assert.equal(falhas, 1);
assert.ok(Math.abs(custoConhecido - 0.0144) < 1e-12);
console.log(JSON.stringify({ natureza: 'simulação determinística, sem modelo',
  tarifa, linhas, resumo: { tarefas: tarefas.length, tentativas,
    falhasTransportePorTentativa: falhas / tentativas,
    tarefasAceitas: linhas.filter(x => x.aceita).length,
    custoConhecido, custoTotalCompleto: linhas.every(x => x.custoCompleto) } }, null, 2));
Um registro útil pode conter identificador técnico da tarefa, etapa, tentativa, duração, versão do modelo, versão das instruções, consumo conhecido e motivo da rejeição. Essa é uma proposta de campos, não um esquema oficial. Use o identificador para relacionar eventos e reserve as métricas agregadas para dimensões controladas, como tipo de tarefa e versão.
Antes de emitir um alerta, descreva o que alguém fará quando ele ocorrer. Uma espera alta na busca pede uma investigação diferente de uma resposta lenta do modelo. Falhas de validação podem exigir revisão do contrato de saída; repetição de chamadas pode indicar uma política de recuperação inadequada. Um painel não corrige essas causas sozinho.
Defina limites conforme o trabalho. Uma análise interna que permite espera não tem o mesmo requisito de uma interação que bloqueia a tela do atendente. Observe distribuições e casos extremos, não apenas uma média que mistura tarefas distintas. Ao comparar versões, preserve a definição das medidas e a natureza dos pedidos; caso contrário, uma mudança de público pode parecer melhoria do modelo.
Limitações e cuidados
Mais telemetria também significa mais responsabilidade. Não registre textos completos, documentos de clientes, credenciais ou dados pessoais apenas porque seriam convenientes para depuração. Prefira medidas e motivos técnicos suficientes para a pergunta investigada; quando conteúdo for realmente necessário, estabeleça acesso, retenção e revisão compatíveis com sua sensibilidade.
O exemplo soma etapas sequenciais e usa aritmética de ponto flutuante com tolerância nas asserções. Ele não inclui concorrência, processamento em partes, descontos, câmbio ou conferência de fatura. A execução bem-sucedida prova os cálculos e verificações desse programa, não que uma integração real seja rápida, barata ou confiável.
Também não confunda telemetria com avaliação completa da qualidade. A existência de fontes, a correção de uma conclusão e a autorização para uma ação exigem critérios próprios. O artigo sobre testes com IA ajuda a manter essa atenção à verificação, sem tomar uma resposta plausível como evidência suficiente.
Conclusão
Acompanhar uma integração com IA começa por separar a tarefa, suas etapas e tentativas. Tempo, consumo e aceite precisam ser relacionados, mas não confundidos. Um custo desconhecido deve continuar desconhecido; uma resposta recebida pode continuar inadequada; uma busca lenta pode explicar a espera mesmo quando o modelo responde normalmente.
Escolha uma tarefa de sua aplicação e registre o suficiente para localizar sua principal dificuldade antes de otimizar. Para ampliar essa prática até decisões de arquitetura e manutenção, consulte o sumário e a degustação de IA Além da Conversa. O aprofundamento interessa justamente quando medir deixa de ser um experimento e passa a sustentar decisões de operação.
Referências
OPENTELEMETRY. Observability primer. OpenTelemetry, [s. d.]. Disponível em: https://opentelemetry.io/docs/concepts/observability-primer/. Acesso em: 3 out. 2026.
OPENTELEMETRY. Semantic conventions for generative AI metrics. GitHub, [s. d.]. Disponível em: https://github.com/open-telemetry/semantic-conventions-genai/blob/main/docs/gen-ai/gen-ai-metrics.md. Acesso em: 3 out. 2026.
OPENTELEMETRY. Semantic conventions for generative client AI spans. GitHub, [s. d.]. Disponível em: https://github.com/open-telemetry/semantic-conventions-genai/blob/main/docs/gen-ai/gen-ai-spans.md. Acesso em: 3 out. 2026.
SILVEIRA, Régys Borges da. Diagnóstico de operação com dados sintéticos. Programa JavaScript e ensaio local. Regys.com.br, 2026. Arquivo de pesquisa: diagnosticar-operacao.mjs.
SILVEIRA, Régys Borges da. IA Além da Conversa: como transformar modelos de linguagem em soluções inteligentes, seguras e operáveis. Livros de Régys Borges da Silveira, 2026. Disponível em: https://livros.regys.com.br/ia-alem-da-conversa. Acesso em: 3 out. 2026.
0 comentário(s)