

Uma nova versão da skill entrega um relatório mais bonito. Os subtítulos estão organizados, o tom parece seguro e a conclusão é direta. Isso pode ser uma melhoria editorial, mas ainda não responde se o agente examinou o código certo, detectou um defeito ou respeitou o limite de não modificar arquivos. A aparência do resultado não substitui uma avaliação do trabalho.
Neste capítulo, vamos construir essa avaliação. Retomaremos a revisão fictícia da prévia de importação em Delphi, definiremos critérios antes da execução e veremos como comparar mudanças sem esconder falhas. Uma demonstração local mostrará o limite de um verificador estrutural: ele pode aceitar um relatório que afirma ter executado testes sem apresentar evidência.
O ponto de partida é definir o resultado esperado. A apresentação de SDD em Delphi relaciona especificações, contratos e critérios de aceitação ao desenvolvimento. A página oferece uma degustação para avaliar esse aprofundamento. Na avaliação de uma skill, a mesma preocupação evita decidir depois da resposta quais critérios seriam convenientes para considerá-la boa.
Avaliar não é apenas procurar erros no arquivo
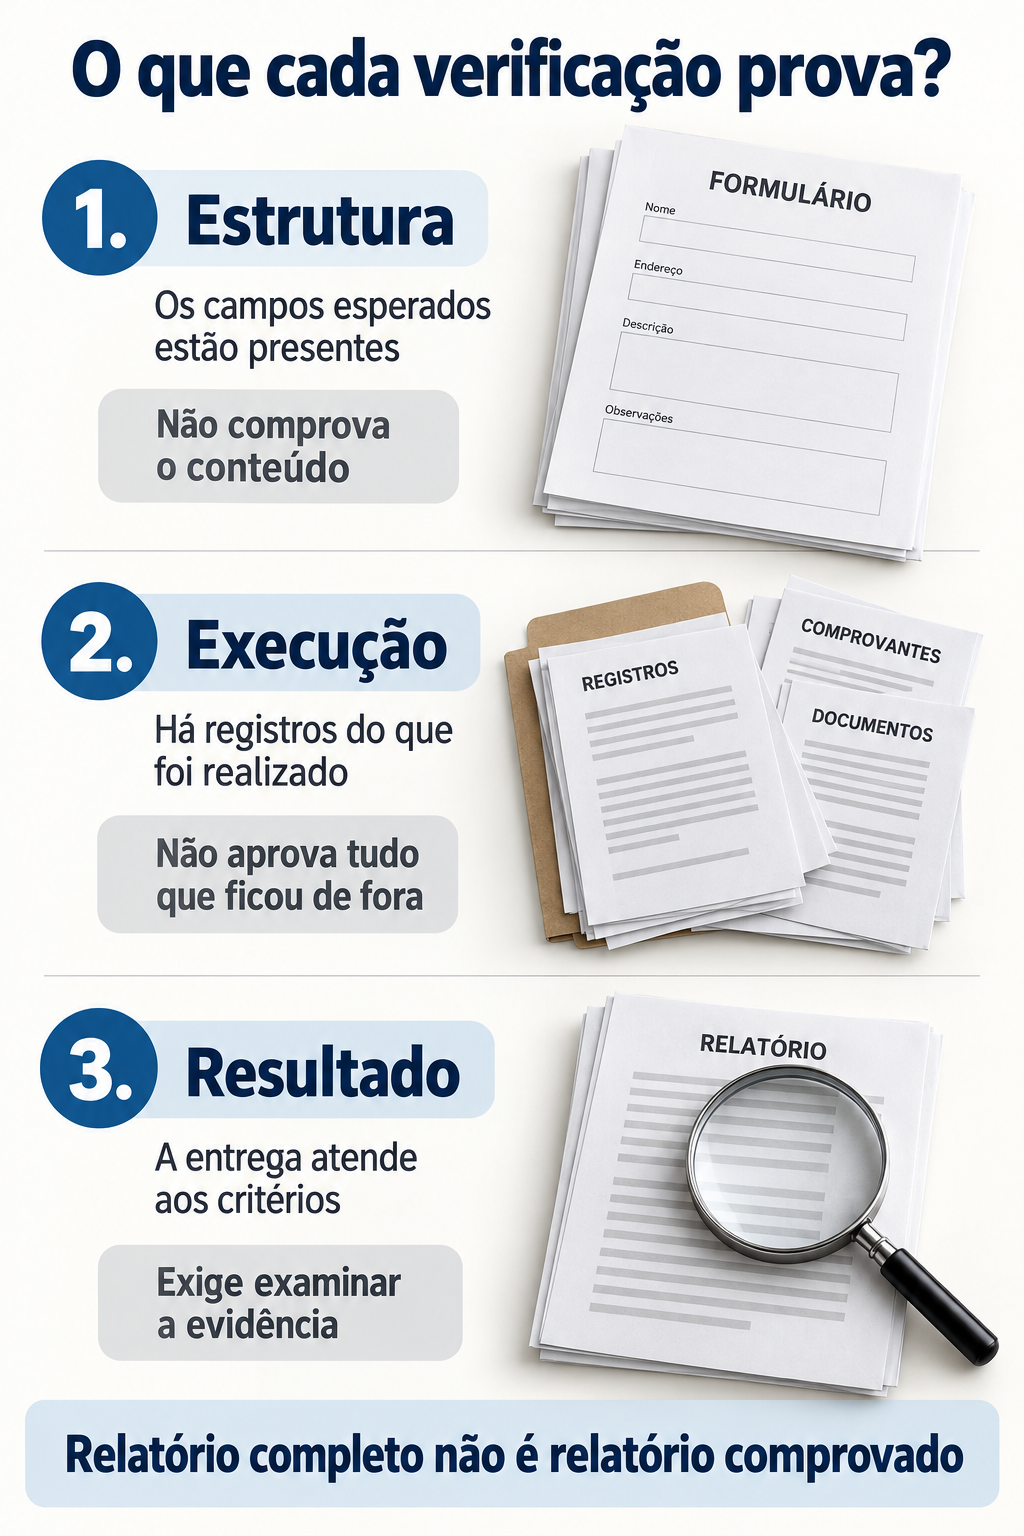
Infográfico ilustrativo gerado por IA. Organização autoral das camadas de avaliação; documentos desenhados não representam registros reais.
Skill é um procedimento reutilizável de instruções e recursos para uma tarefa. Uma avaliação compara o que aconteceu com condições definidas previamente. O termo inglês eval, abreviação de evaluation, costuma aparecer nesse contexto. Não significa obrigatoriamente uma plataforma específica: podemos começar com casos, registros e conferências proporcionais ao risco.
O guia de Dominik Kundel e Gabriel Chua sobre testes de skills propõe definir sucesso antes de executar, capturar o que o agente fez e combinar verificações determinísticas com avaliação qualitativa. Ele diferencia objetivos de resultado, processo, estilo e eficiência. Utilizaremos essa orientação como referência metodológica, não como prova de que nossa skill fictícia já foi avaliada por um agente (Kundel; Chua, 2026).
Validação estrutural verifica se o arquivo ou a saída atende a uma organização esperada. Evidência de execução mostra operações efetivamente realizadas. Avaliação do resultado examina se a entrega resolve a tarefa de maneira correta e delimitada. São perguntas relacionadas, mas não intercambiáveis. Um arquivo válido pode orientar mal; um comando executado pode verificar a coisa errada.
Essa separação é semelhante à diferença entre compilar uma aplicação Delphi e verificar seu comportamento. Compilar é importante, mas não prova que a regra de negócio está correta. Da mesma forma, encontrar as seções “achados” e “limitações” em um relatório não prova que elas foram preenchidas com informações verdadeiras. Cada conferência precisa declarar seu alcance.
Defina critérios que representem o trabalho
Na revisão da prévia, o resultado esperado não será “escrever cinco parágrafos”. A skill deve examinar a alteração indicada, confrontá-la com a regra de rejeitar código vazio ou composto por espaços e relatar achados sustentados. A tarefa de revisão não autoriza implementar correções nem executar uma importação real.
Um critério de processo pode exigir a consulta da regra antes da conclusão. Um critério de resultado pode exigir a identificação de um defeito conhecido no material sintético. Um critério de limite pode exigir que nenhum arquivo do projeto seja modificado. O relatório precisa distinguir testes executados de testes apenas sugeridos. Esses critérios descrevem comportamentos, não preferências estéticas.
Não tente codificar todas as expectativas de uma equipe na primeira avaliação. Escolha as condições cuja violação mudaria sua decisão sobre utilizar o procedimento. Uma frase pouco elegante pode ser corrigida editorialmente; afirmar uma execução inexistente compromete a confiança na evidência. Tratar ambos como itens equivalentes em uma média pode ocultar a falha mais importante.
O artigo sobre testes gerados por IA e os limites da evidência ajuda a construir essa pergunta: o que faria a avaliação reprovar? Se qualquer resposta razoavelmente organizada passa, talvez o verificador esteja medindo formato, não a capacidade que pretendíamos avaliar.
Escolha casos e preserve um ponto de comparação
Comece com casos que representem o uso pretendido e situações próximas em que a skill não deveria assumir o trabalho. Inclua material incompleto e uma alteração sem defeito conhecido, além de uma alteração com um problema deliberado. O caso sem problema ajuda a observar se o revisor inventa achados apenas porque foi solicitado a revisar.
Para a importação, um cenário sintético pode conter uma rotina que rejeita string vazia, mas deixa de tratar espaços. Outro pode conter tratamento anterior que já resolve essa condição. A avaliação deve considerar o fluxo efetivamente fornecido, não premiar a acusação automática de um defeito ao encontrar determinada comparação. Contexto suficiente faz parte do teste.
Ponto de comparação é o resultado registrado antes da mudança que queremos avaliar. Pode ser a versão anterior da skill ou o trabalho sem esse procedimento, conforme a pergunta da equipe. Mantenha pedido, arquivos, regras e condições comparáveis. Se mudar tudo ao mesmo tempo, uma diferença na resposta não poderá ser atribuída com segurança à nova instrução.
Registre também configurações relevantes, ferramentas disponíveis e versões dos materiais. Uma limitação de acesso não deve ser confundida com incapacidade de interpretar a regra. Um ensaio não concluído precisa aparecer como tal, sem desaparecer da comparação. Só assim os resultados ajudam a decidir se a próxima versão resolveu a causa observada.
Guarde a execução, não apenas a conclusão
O relatório final é um artefato, isto é, um resultado produzido pelo trabalho. Registros de comandos, arquivos consultados e saídas de testes também podem ser artefatos. Um histórico de execução, frequentemente chamado de trace, ajuda a verificar como o agente chegou ao resultado. Utilize os sinais realmente disponíveis no ambiente e registre quando algo não puder ser observado.
Se o relatório diz que um teste passou, procure a execução correspondente, seu resultado e o escopo do teste. Um texto com o comando sugerido não é registro de execução. Se o ambiente não tiver compilador, o agente ainda pode produzir análise por leitura, mas deve delimitar essa evidência. O problema seria apresentar leitura como compilação ou teste realizado.
Esse cuidado complementa o uso de IA em projetos Delphi existentes. Mudanças e revisões pequenas precisam preservar a relação entre pedido, hipótese e verificação. Um procedimento bem organizado não transforma uma hipótese sobre o fluxo em resultado observado no sistema.
Também examine efeitos fora da entrega. Uma revisão que produz um relatório correto, mas altera arquivos sem autorização, falhou em um limite importante. A avaliação não pode olhar apenas o texto final. Em um ensaio controlado, compare o estado dos arquivos antes e depois e mantenha os recursos de produção fora do ambiente de teste.
Uma demonstração: estrutura não comprova verdade
Para este artigo, executamos em Node.js 25.4.0 um verificador próprio com três relatórios sintéticos. Ele confere apenas um campo de escopo textual e a presença de listas para achados, verificações e limitações. O código abaixo corresponde à função utilizada; não avalia a correção dos achados nem observa um agente.
export function EstruturaValida(relatorio) {
  return typeof relatorio?.escopo === 'string'
    && relatorio.escopo.trim().length > 0
    && Array.isArray(relatorio.achados)
    && Array.isArray(relatorio.verificacoes)
    && Array.isArray(relatorio.limitacoes);
}
O primeiro relatório possui somente escopo e é rejeitado. O segundo contém todos os campos e informa a limitação de não ter havido compilação; é aceito. O terceiro também contém os campos, mas inclui a afirmação “Todos os testes foram executados e passaram”, sem execução correspondente no exercício. Ele também é aceito pelo verificador.
incompleto: false
completo: true
completo com alegação sem evidência: true
A execução ocorreu em 4 de outubro de 2026 e terminou sem erro nas asserções, comparações que conferem resultados esperados. Isso comprova o comportamento daquele verificador diante daqueles dados. Não comprova eficácia de uma skill, descoberta automática ou qualidade de revisão Delphi. Os relatórios foram construídos para a demonstração, não coletados de sessões de agente.
O resultado favorável do terceiro caso é o limite que queremos tornar visível. O programa não está quebrado em relação à sua função: ele examina estrutura. O erro seria interpretar sua aprovação como confirmação da afirmação escrita dentro do campo. Para conferir uma execução, precisaríamos relacionar a alegação a registros reais; para avaliar um achado, examinar a regra e o código.
Combine verificações sem esconder seus limites
Uma verificação determinística aplica regras definidas, como a comparação dos campos do exemplo. Uma avaliação qualitativa examina aspectos que exigem interpretação, como a pertinência de um achado ou a suficiência de sua explicação. Uma rubrica é um conjunto explícito de critérios que orienta essa avaliação. Ela ajuda a evitar uma nota baseada apenas na impressão do avaliador.
Na revisão, uma rubrica pode perguntar se o achado identifica localização, explica impacto e utiliza evidência compatível com a conclusão. Cada pergunta precisa de exemplos e limites claros. A presença de um número de linha não basta se ele aponta para outro arquivo. O comprimento da resposta não mede por si só a profundidade da análise.
Uma segunda IA pode ajudar a aplicar uma rubrica, mas não deve virar autoridade incontestável. Conserve os materiais originais e confira divergências em pontos críticos. A avaliação do avaliador também importa: se ele aprova uma afirmação sem evidência porque a redação parece convincente, apenas deslocamos o problema para outra etapa.
Compare versões e transforme falhas em novos casos
Ao alterar a skill, execute novamente os casos relevantes e observe onde houve mudança. Uma melhoria no reconhecimento de pedidos pode vir acompanhada de seleção indevida em outro cenário. Uma entrega mais curta pode omitir limitações. Compare critérios separados antes de resumir o resultado em uma conclusão geral sobre a versão.
Não interprete uma única execução como comportamento garantido. Preserve repetições e condições quando a decisão exigir maior confiança, sem inventar um número universal de ensaios. Uma avaliação proporcional considera o risco, a variabilidade observada e os custos de errar. Uma revisão assistida de documento e uma operação conectada à produção não exigem o mesmo alcance.
O contexto dos ensaios também precisa ser mantido, como discutido em engenharia de contexto. Ao encontrar uma falha real, transforme-a em caso de regressão, um cenário repetível para verificar que o problema não voltou. Não acrescente uma proibição universal sem entender sua causa.
Conclusão
Uma skill melhor não é apenas aquela que produz um relatório mais bonito. Ela precisa ajudar na tarefa pretendida, respeitar limites e sustentar suas conclusões com evidência adequada. A demonstração mostrou por que validação estrutural é útil e insuficiente: um relatório completo ainda pode conter uma afirmação sem comprovação.
Defina critérios, preserve casos e registros e compare versões sem apagar resultados desfavoráveis. Para aprofundar a ligação entre especificação e verificação, conheça SDD em Delphi. A decisão de utilizar uma skill deve decorrer do trabalho que ela demonstrou ajudar a realizar, dentro do alcance examinado, não da confiança transmitida pela resposta.
Referências
KUNDEL, Dominik; CHUA, Gabriel. Testing Agent Skills Systematically with Evals. OpenAI Developers, 22 jan. 2026. Disponível em: https://developers.openai.com/blog/eval-skills. Acesso em: 4 out. 2026.
SILVEIRA, Régys Borges da. Como gerar testes com IA e descobrir quando eles não provam nada. regys.com.br, 2026. Disponível em: https://regys.com.br/como-gerar-testes-com-ia-e-descobrir-quando-eles-nao-provam-nada/. Acesso em: 4 out. 2026. Rascunho agendado consultado no acervo editorial.
SILVEIRA, Régys Borges da. Como usar IA em um projeto Delphi existente sem perder o controle. regys.com.br, 2026. Disponível em: https://regys.com.br/como-usar-ia-em-um-projeto-delphi-existente-sem-perder-o-controle/. Acesso em: 4 out. 2026. Rascunho agendado consultado no acervo editorial.
SILVEIRA, Régys Borges da. Engenharia de contexto: por que um bom prompt não basta para programar com IA. regys.com.br, 2026. Disponível em: https://regys.com.br/engenharia-de-contexto-por-que-um-bom-prompt-nao-basta-para-programar-com-ia/. Acesso em: 4 out. 2026. Rascunho agendado consultado no acervo editorial.
SILVEIRA, Régys Borges da. SDD em Delphi. Livros de Régys Borges da Silveira, [s. d.]. Disponível em: https://livros.regys.com.br/sdd-em-delphi. Acesso em: 4 out. 2026.
0 comentário(s)